循环神经网络
本篇目录:
循环神经网络简介
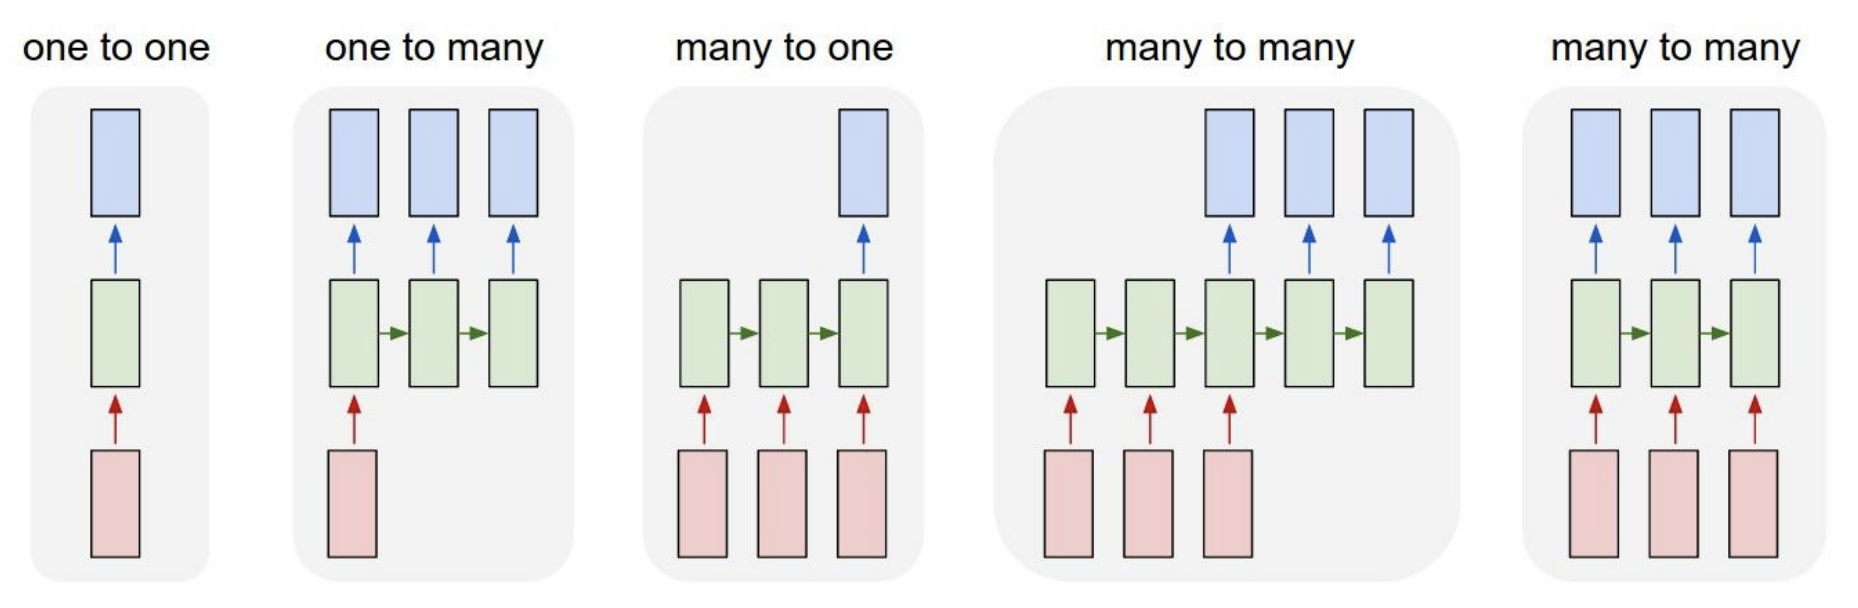
本篇介绍循环神经网络(RNN)。RNN 的一个重要特点,是网络架构的连接方式非常灵活。普通神经网络通常接收固定长度的输入向量(红色),经过若干隐藏层(绿色),输出固定长度的向量(蓝色),如图 1 最左侧所示。这种普通神经网络为单张输入图像输出一个标签,而有些任务需要输出一个序列,例如图中的一对多结构。循环神经网络可以处理输入序列、输出序列,或同时处理两者。* 一对多的例子是图像描述生成:输入固定大小的图像,通过 RNN 输出描述图像内容的词序列(图 1 第二种结构)。* 多对一的例子是动作预测:输入一系列视频帧,输出视频中动作的类别(第三种结构)。自然语言处理中的情感分类也是一例:输入句子的词序列,判断其情感是正面还是负面。* 多对多的例子是视频描述生成:输入视频帧序列,输出描述视频内容的词序列(第四种结构)。机器翻译也是如此,例如接收英文句子的词序列,生成法文句子的词序列。* 图 1 最右侧还展示了多对多的一种变体,它在每个时间步都产生输出,例如对视频逐帧分类。此时,我们不仅希望当前帧的预测取决于当前输入,也希望它利用此前各帧的信息。
总体而言,RNN 可以构造这样的网络:每个时间步的预测都取决于此前各时间步所积累的信息。
已有的卷积网络为什么不够用?
已有的卷积网络不足以直接处理输入、输出序列长度可变的任务。以视频描述生成为例,输入帧数可能相差很大,例如 10 分钟与 10 小时的视频;输出描述的长度也不固定。这里讨论的卷积网络要求输入具有固定宽高,无法直接推广到不同长度的输入。因此引入循环神经网络(RNN)来处理这类问题。
循环神经网络
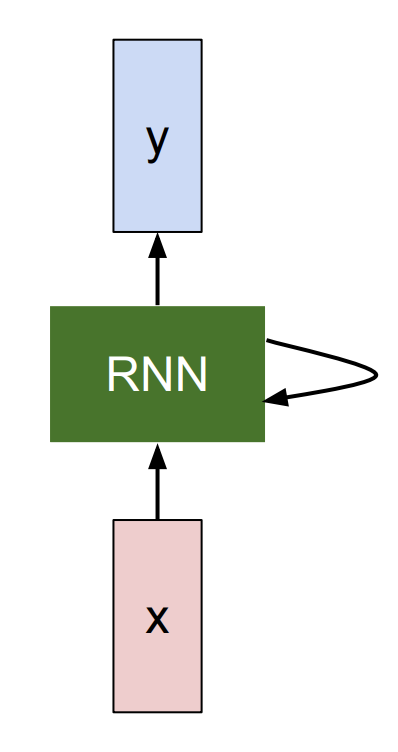
可以把 RNN 看作图 2 左侧的黑盒:它有一个随序列处理而更新的“内部状态”。每个时间步输入一个向量,网络根据收到的信息修改状态。改变 RNN 权重,就会改变状态随输入演化的方式。此外,还可以根据当前状态计算输出,因此可以在 RNN 上方接出输出向量,如图 2 所示。
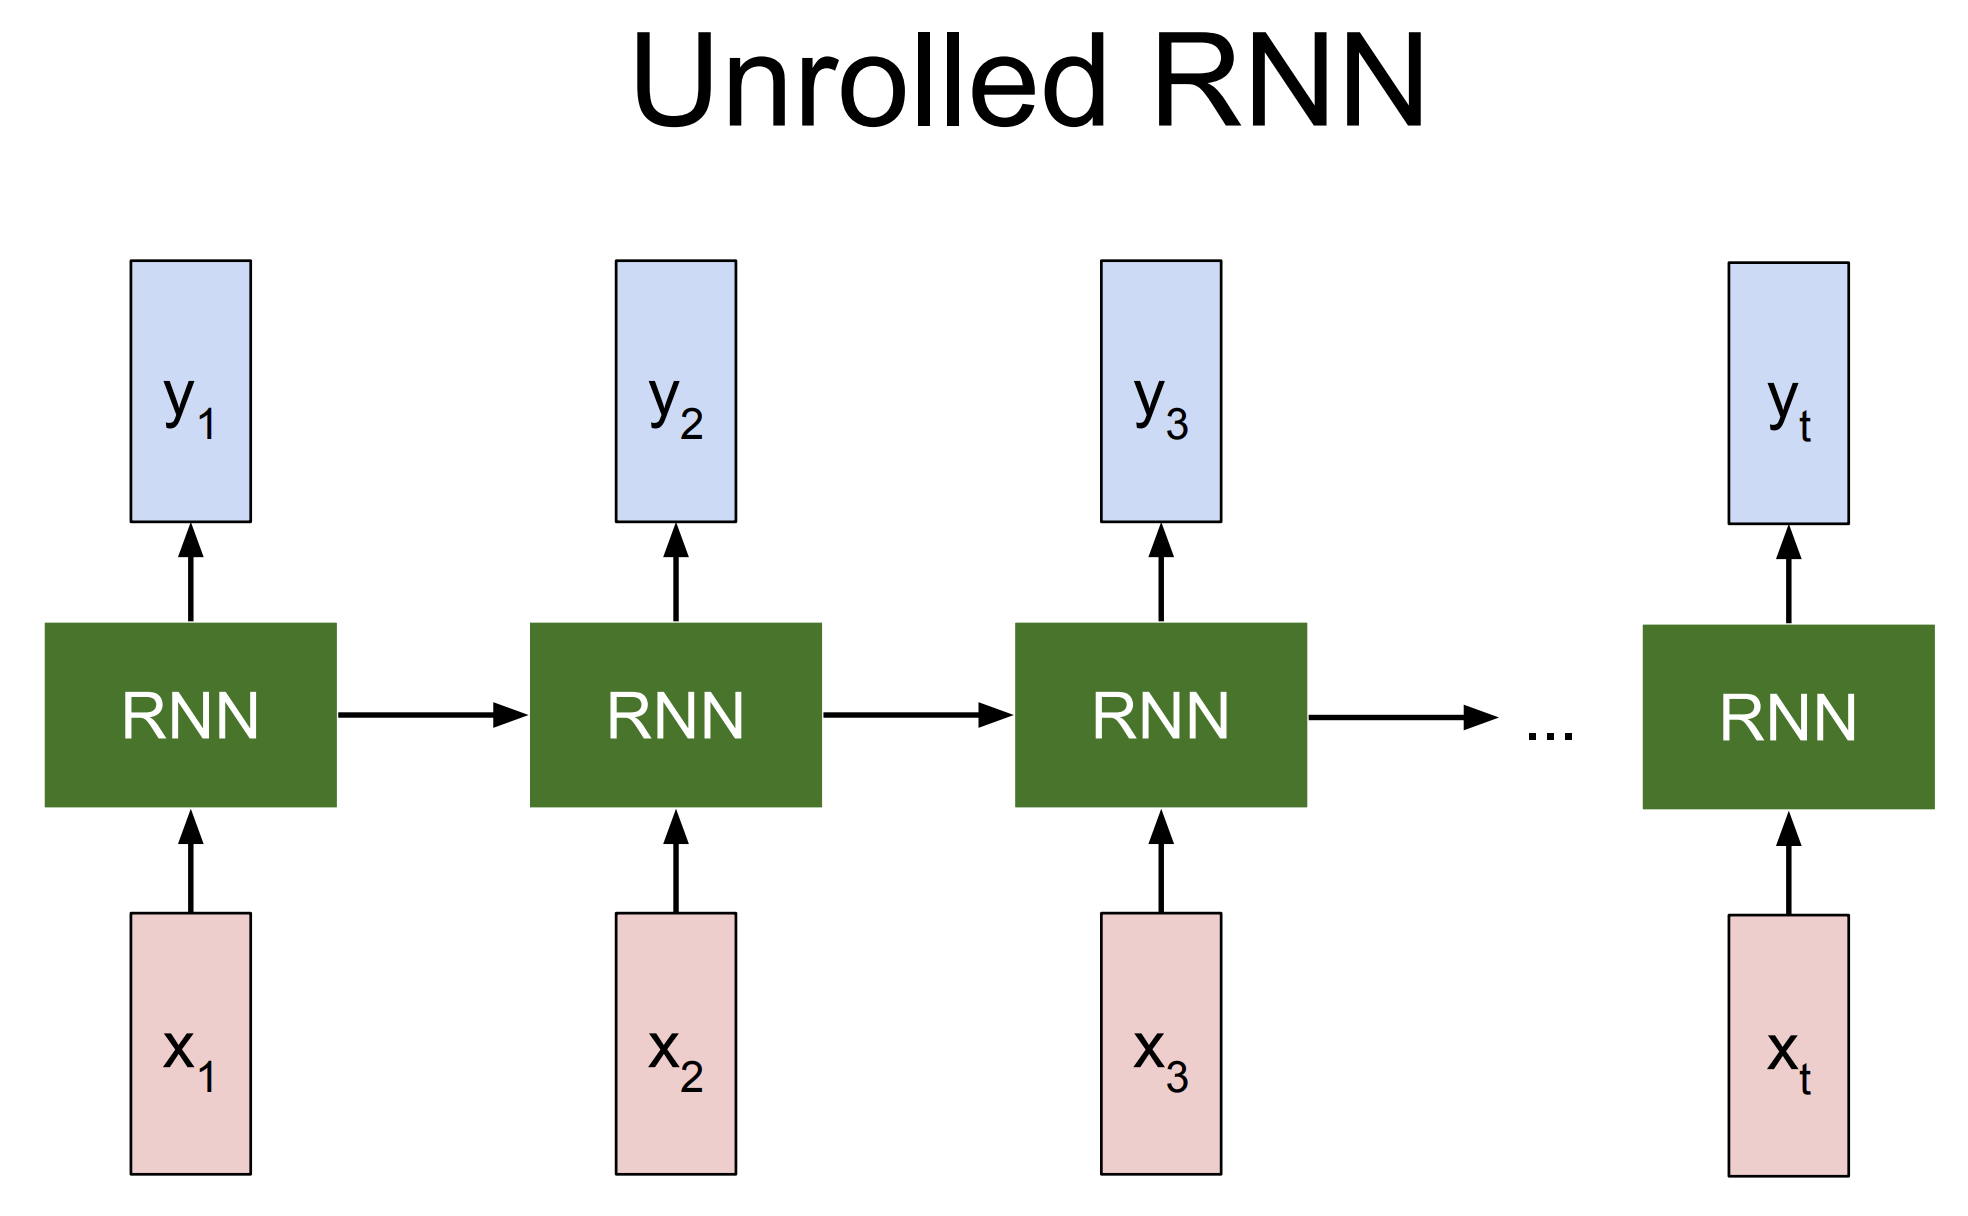
把 RNN 按时间展开后(图 2 右),不同时间步的输入(如视频帧)记为 $$x_1, x_2, x_3$$ 到 $$x_t$$。每个时间步都接收当前输入帧 $$x_i$$,以及对此前所见内容的表示,也就是历史状态;据此生成输出 $$y_i$$ 并更新历史状态,再沿时间向后传递。右图各个 RNN 模块实际上是同一个模块,参数共享,只是各时间步的输入与历史状态不同。
更准确地说,RNN 可以用带参数 $$W$$ 的函数 $$f_W$$ 所定义的递推关系表示:
$$ h_t = f_W(h_{t-1}, x_t) $$
每个时间步接收上一个时间步 $$t-1$$ 的状态向量 $$h_{t-1}$$,以及当前输入向量 $$x_t$$,得到当前状态向量 $$h_t$$。所有时间步使用同一个函数 $$f_W$$ 和同一组权重 $$W$$,因此不必预先限定序列长度:无论输入或输出序列多长,都重复应用同一函数。
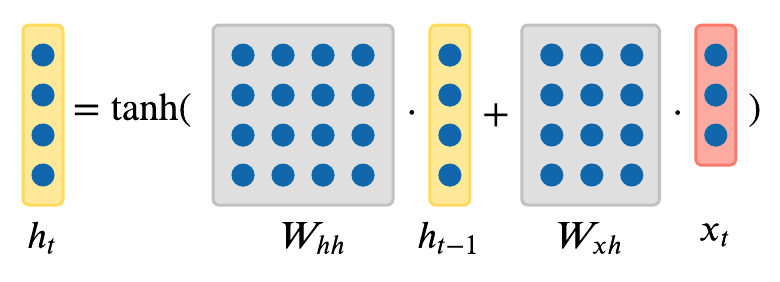
最简单的 RNN 称为基本 RNN(Vanilla RNN),网络只维护一个隐藏状态 $$h$$。递推公式说明如何由前一隐藏状态 $$h_{t-1}$$ 和当前输入 $$x_t$$ 更新 $$h$$:分别使用权重矩阵 $$W_{hh}$$、$$W_{xh}$$ 对前一时间步的状态 $$h_{t-1}$$ 和当前输入 $$x_t$$ 作线性变换,将结果相加,再经过 $$tanh$$ 函数,得到时间步 $$t$$ 的隐藏状态 $$h_t$$。这个递推关系描述了 $$h$$ 如何同时依赖历史信息与当前输入:
$$ h_t = tanh(W_{hh}h_{t-1} + W_{xh}x_t) $$
再对隐藏状态做一次矩阵变换,就能根据 $$h_t$$ 计算预测。这便构成了最简单的完整网络:
$$ y_t = W_{hy}h_t $$
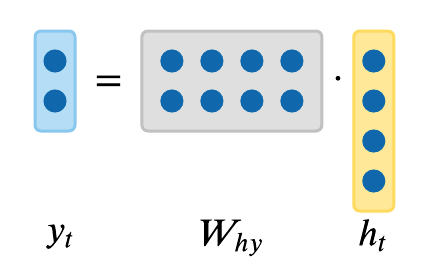
目前仅用抽象向量 $$x, h, y$$ 描述了 RNN。下面通过具体任务赋予这些向量实际含义。
RNN 示例:字符级语言模型
字符级语言模型是使用 RNN 的一个简单、直观的例子。我们将字符序列依次输入 RNN,并在每个时间步要求它预测下一个字符。模型根据此前看到的序列,为词表中的各个候选字符输出得分,表示哪个字符更可能接着出现。
在图 3 的简单例子中,训练序列只有字符串 $$\text{"hello"}$$,整个数据集的字符表 $$V \in \{\text{"h"}, \text{"e"}, \text{"l"}, \text{"o"}\}$$ 只有 4 个字符。目标是让 RNN 根据这些训练数据,学会预测序列中的下一个字符。
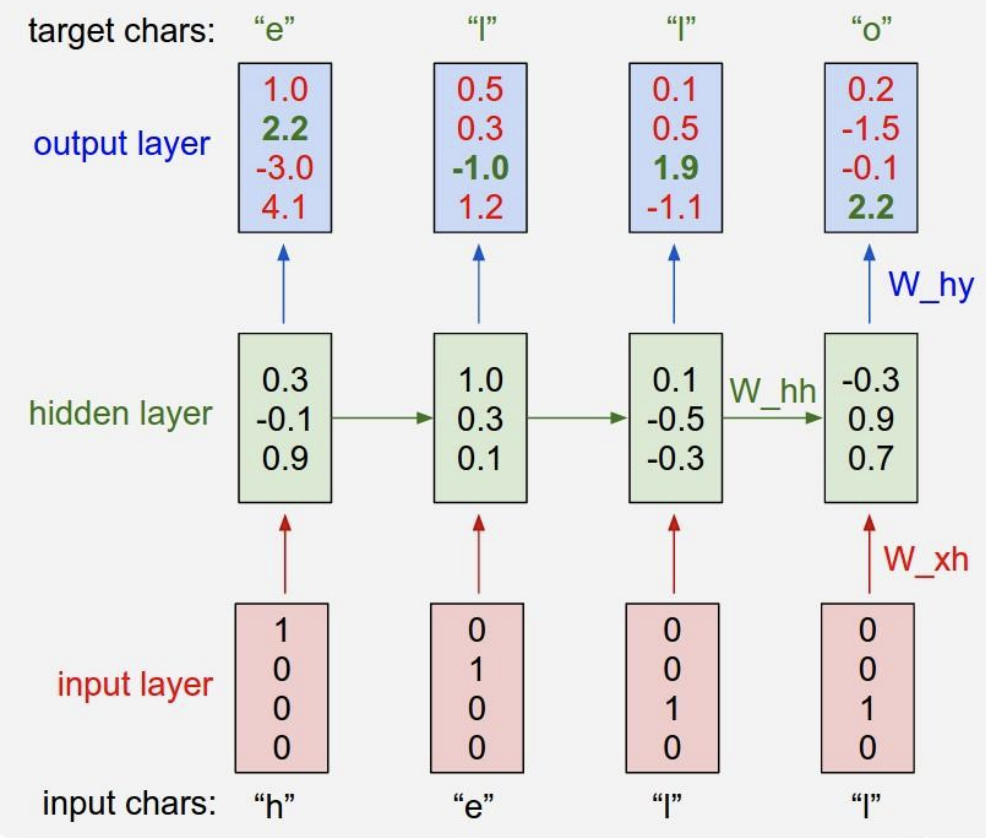
如图 3 所示,每次向 RNN 输入一个字符,依次为 $$\text{"h"}$$、$$\text{"e"}$$、$$\text{"l"}$$,最后是 $$\text{"l"}$$。字符采用独热向量(one-hot)编码:每个字符对应一个唯一的位置,只有该位置为 1,其余位置都为 0。例如:
$$ \begin{bmatrix}1 \\ 0 \\ 0 \\ 0 \end{bmatrix} = \text{"h"}\ \ \begin{bmatrix}0 \\ 1 \\ 0 \\ 0 \end{bmatrix} = \text{"e"}\ \ \begin{bmatrix}0 \\ 0 \\ 1 \\ 0 \end{bmatrix} = \text{"l"}\ \ \begin{bmatrix}0 \\ 0 \\ 0 \\ 1 \end{bmatrix} = \text{"o"} $$
接着,在每个时间步应用前面的递推公式。设初始状态 $$h$$ 是长度为 3 的全零向量,利用同一递推公式即可得到下一个隐藏状态的三维表示 $$h$$;在任意时刻,该状态都概括了此前输入的全部字符信息:
$$ \begin{aligned} \begin{bmatrix}0.3 \\ -0.1 \\ 0.9 \end{bmatrix} &= f_W(W_{hh}\begin{bmatrix}0 \\ 0 \\ 0 \end{bmatrix} + W_{xh}\begin{bmatrix}1 \\ 0 \\ 0 \\ 0 \end{bmatrix}) \ \ \ \ &(1) \\ \begin{bmatrix}1.0 \\ 0.3 \\ 0.1 \end{bmatrix} &= f_W(W_{hh}\begin{bmatrix}0.3 \\ -0.1 \\ 0.9 \end{bmatrix} + W_{xh}\begin{bmatrix}0 \\ 1 \\ 0 \\ 0 \end{bmatrix}) \ \ \ \ &(2) \\ \begin{bmatrix}0.1 \\ -0.5 \\ -0.3 \end{bmatrix} &= f_W(W_{hh}\begin{bmatrix}1.0 \\ 0.3 \\ 0.1 \end{bmatrix} + W_{xh}\begin{bmatrix}0 \\ 0 \\ 1 \\ 0 \end{bmatrix}) \ \ \ \ &(3) \\ \begin{bmatrix}-0.3 \\ 0.9 \\ 0.7 \end{bmatrix} &= f_W(W_{hh}\begin{bmatrix}0.1 \\ -0.5 \\ -0.3 \end{bmatrix} + W_{xh}\begin{bmatrix}0 \\ 0 \\ 1 \\ 0 \end{bmatrix}) \ \ \ \ &(4) \end{aligned} $$
每次递推后,都要预测序列中的下一个字符。由于字符表 $$V$$ 中共有 4 个字符,因此每个时间步输出一个四维的未归一化得分向量(logits)。
图 3 的第一个时间步输入 $$\text{"h"}$$,RNN 根据当前权重计算出得分向量:
$$ \begin{bmatrix}1.0 \\ 2.2 \\ -3.0 \\ 4.1 \end{bmatrix} \rightarrow \begin{bmatrix}\text{"h"} \\ \text{"e"} \\ \text{"l"}\\ \text{"o"} \end{bmatrix} $$
此时,RNN 为候选字符 $$\text{"h"}$$、$$\text{"e"}$$、$$\text{"e"}$$、$$\text{"o"}$$ 给出的得分分别为 $$1.0$$、$$2.2$$、$$-3.0$$、$$4.1$$。因为 $$4.1$$ 的得分最高,网络错误地预测下一个字符应为 $$\text{"o"}$$。但训练序列告诉我们,$$\text{"h"}$$ 后应当接 $$\text{"e"}$$;因此图中绿色标出的 $$2.2$$ 才是正确答案对应的得分,我们希望提高它并降低其他得分。每个时间步都有一个目标字符,所以可以将误差信号作为损失函数的梯度沿连接反向传播。例如,可以使用 Softmax 分类对应的损失,将各时间步的损失向后传播,计算所有权重矩阵的梯度,据此更新参数,使 RNN 输出正确的概率分布。同样的方法可以推广到更大的训练数据集。
多层循环神经网络
前面仅展示了单层 RNN,但网络并不限于一层。可以把多个 RNN 逐层堆叠,形成更深的结构;经验上,更深的架构往往效果更好,如图 4 所示。
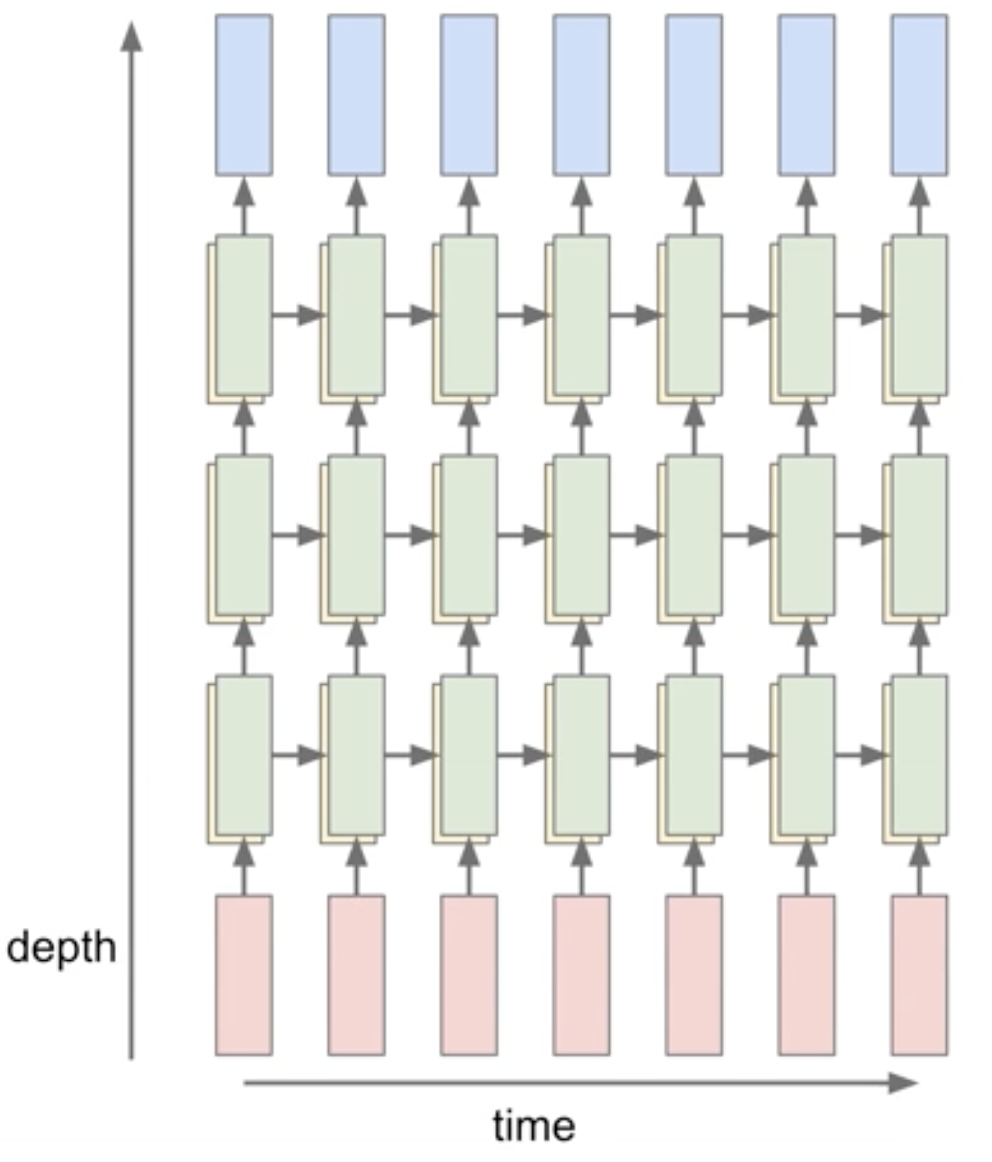
例如,图 4 包含三个各自拥有独立权重的 RNN,并将它们上下堆叠。第二层 RNN 的输入是第一层 RNN 的隐藏状态向量。所有层联合训练,整张图表示一个统一的计算图。
长短期记忆网络(LSTM)
目前介绍的是基本 RNN 的简单递推公式。在实践中很少直接使用这一形式,通常会采用长短期记忆网络(LSTM)。
基本 RNN 中的梯度传播与梯度消失问题
RNN 模块接收输入 $$x_t$$ 和上一隐藏表示 $$h_{t-1}$$,经过可学习的变换,再通过 tanh 得到下一时间步的隐藏表示 $$h_{t}$$,并产生输出 $$y_{t}$$,如下式所示。
$$ h_t = tanh(W_{hh}h_{t-1} + W_{xh}x_t) $$
考察反向传播时,重点看最后一个时间步的输出如何影响最早时间步的权重。$$h_t$$ 对 $$h_{t-1}$$ 的偏导数可写为:$$ \frac{\partial h_t}{\partial h_{t-1}} = tanh^{'}(W_{hh}h_{t-1} + W_{xh}x_t)W_{hh} $$
通过计算最后一个时间步的损失 $$L_{t}$$ 对 $$W_{hh}$$ 的导数,来更新权重 $$W_{hh}$$。
$$ \begin{aligned} \frac{\partial L_{t}}{\partial W_{hh}} = \frac{\partial L_{t}}{\partial h_{t}} \frac{\partial h_{t}}{\partial h_{t-1} } \dots \frac{\partial h_{1}}{\partial W_{hh}} \\ = \frac{\partial L_{t}}{\partial h_{t}}(\prod_{t=2}^{T} \frac{\partial h_{t}}{\partial h_{t-1}})\frac{\partial h_{1}}{\partial W_{hh}} \\ = \frac{\partial L_{t}}{\partial h_{t}}(\prod_{t=2}^{T} tanh^{'}(W_{hh}h_{t-1} + W_{xh}x_t)W_{hh}^{T-1})\frac{\partial h_{1}}{\partial W_{hh}} \\ \end{aligned} $$
-
梯度消失:由于 tanh 的输出位于 −1 到 1 之间,$$tanh^{'}(W_{hh}h_{t-1} + W_{xh}x_t)$$ 几乎总小于 1。随着 $$t$$ 增大,也就是跨越更多时间步,梯度 $$\frac{\partial L_{t}}{\partial W} $$ 会不断衰减并接近 0。这就是梯度消失:较晚时间步的误差信号难以有效传回最早的时间步。处理长序列时,这会使相关参数更新极其缓慢。
-
移除非线性函数 tanh:如果试图通过去掉 tanh 来解决梯度消失,剩下的形式为:
$$ \begin{aligned} \frac{\partial L_{t}}{\partial W} = \frac{\partial L_{t}}{\partial h_{t}}(\prod_{t=2}^{T} W_{hh}^{T-1})\frac{\partial h_{1}}{\partial W} \end{aligned} $$- 梯度爆炸:如果 W_{hh} 的最大奇异值大于 1,梯度会不断放大,从较晚时间步反传回来时可能变得非常大,甚至出现 NaN。
- 梯度消失:如果 W_{hh} 的最大奇异值小于 1,仍会发生前述梯度消失问题,使学习速度明显变慢。
实践中,可以用梯度裁剪处理梯度爆炸:把过大的梯度限制在给定阈值内。然而,当 W_{hh} 的最大奇异值小于 1 时,梯度消失依然存在。LSTM 正是为缓解这一问题而设计的。
LSTM 的计算公式
下面给出 LSTM 的具体公式。在时间步 $$t$$,网络有隐藏状态 $$h_t$$ 和细胞状态 $$c_t$$,其中 $$h_t$$、$$c_t$$ 都是长度为 $$n$$ 的向量。相比基本 RNN,LSTM 增加了细胞状态 $$c_t$$,可以直观地将 $$c_t$$ 理解为长期信息的存储。网络可以从细胞状态 $$c_t$$ 读取、擦除或写入信息,并通过三个门控制对 $$c_t$$ 的操作:$$i, f, o$$ 分别对应输入门、遗忘门和输出门。门值从 0(关闭)变化到 1(打开);$$i, f, o$$ 都是长度为 $$n$$ 的向量。
每个时间步给定输入向量 $$x_t$$、前一隐藏状态 $$h_{t-1}$$ 和前一细胞状态 $$c_{t-1}$$,LSTM 按下面的公式计算时间步 $$t$$ 的新隐藏状态 $$h_t$$ 与新细胞状态 $$c_t$$:
$$ \begin{aligned} f_t &= \sigma(W_{hf}h_{t_1} + W_{xf}x_t) \\ i_t &= \sigma(W_{hi}h_{t_1} + W_{xi}x_t) \\ o_t &= \sigma(W_{ho}h_{t_1} + W_{xo}x_t) \\ g_t &= \text{tanh}(W_{hg}h_{t_1} + W_{xg}x_t) \\ \end{aligned} $$
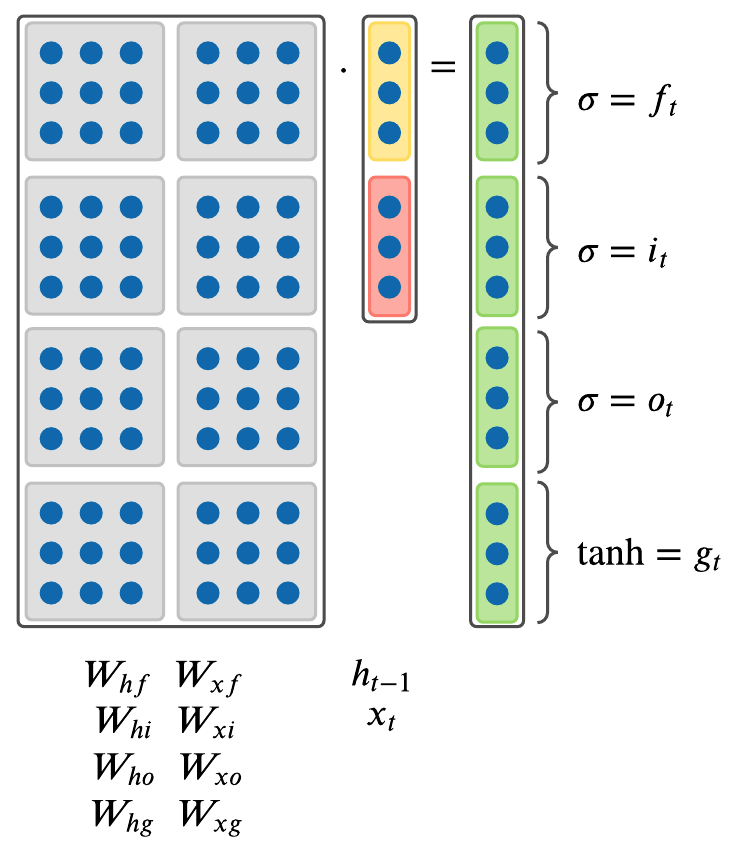
$$ \begin{aligned} c_t &= f_t \odot c_{t-1} + i_t \odot g_t \\ h_t &= o_t \odot \text{tanh}(c_t) \\ \end{aligned} $$
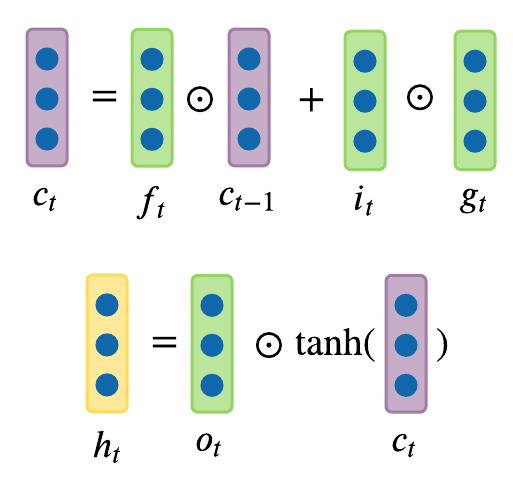
其中 $$\odot$$ 表示逐元素的 Hadamard 乘积。公式中的 $$g_t$$ 是一个中间计算结果,随后与输入门 $$o$$ 配合使用。
由于各门向量 $$f, i, o$$ 经过 sigmoid 函数 $$\sigma$$,其分量都在 0 到 1 之间。结合逐元素乘法,可以看出:
- 遗忘门:时间步 $$t$$ 的遗忘门 $$f_t$$ 控制从前一细胞状态 $$c_{t-1}$$ 中“移除”多少信息。它学习哪些历史表示应当被擦除,因此 LSTM 同时维护隐藏状态 $$h_t$$ 和细胞状态 $$c_t$$。$$c_t$$ 沿时间传递,由网络学习应保留还是遗忘前一细胞状态中的信息。
- 输入门:时间步 $$t$$ 的输入门 $$i_t$$ 控制从前一隐藏状态 $$h_{t-1}$$ 与当前输入 $$x_t$$ 中,向新的细胞状态 $$c_t$$ “写入”多少信息。输入门 $$i$$ 使用 sigmoid 而不是 tanh,把输入映射到 0 与 1 之间,类似一个接近关闭或打开的开关。它决定接纳多少由候选计算单元 $$g$$ 产生的信息,并将候选输出与输入门 $$i$$ 逐元素相乘。
- 输出门:时间步 $$t$$ 的输出门 $$o_t$$ 控制有多少信息通过当前隐藏状态 $$h_t$$ 对外输出。
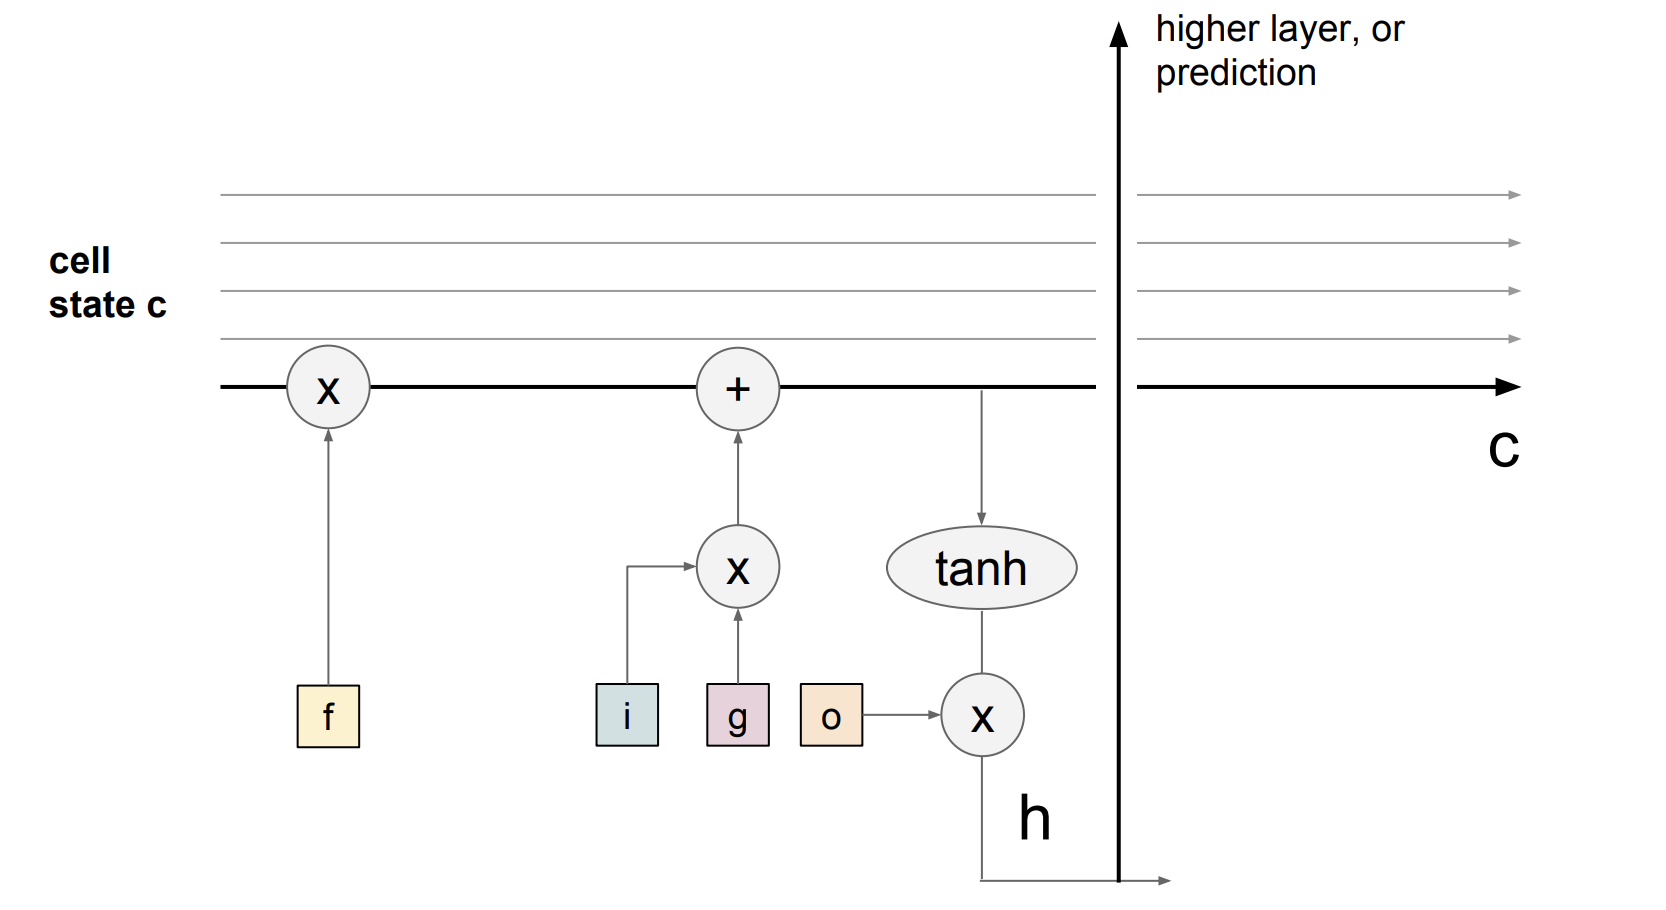
LSTM 的关键是细胞状态,即沿各时间步横向贯通的那条路径。可以将其想象为信息通道:信息沿整条链直接传递,只受到少量线性交互。上述公式使信息容易沿这条通道流动(图 5)。因此,即使堆叠多个 LSTM,梯度也能沿细胞状态而不是隐藏状态 $$h$$ 反向传递,避免在每个时间步都经历同样的衰减。
这在很大程度上缓解了前面讨论的梯度消失与爆炸问题。图 5 还表明,梯度中包含遗忘门的激活向量,因此适当调整遗忘门的参数,可以更好地控制梯度大小。
LSTM 能否解决梯度消失问题?
LSTM 更容易跨越多个时间步保留信息。例如,若遗忘门为 1、输入门为 0,细胞状态中的信息便可一直保留。相比之下,基本 RNN 仅依靠单个权重矩阵,要在多次递推中维持隐藏状态里的信息要困难得多。
LSTM 并不保证完全消除梯度消失或爆炸,但确实让模型更容易学习长距离依赖。