神经网络(三):训练与评估
本篇目录:
- 梯度检查
- 基本正确性检查
- 监控训练过程
- 损失函数
- 训练/验证准确率
- 权重:更新比率
- 每层的激活/梯度分布
- 可视化
- 参数更新
- 一阶 (SGD)、动量、Nesterov 动量
- 学习率退火
- 二阶方法
- 每参数自适应学习率(Adagrad、RMSProp)
- 超参数优化
- 评估
- 模型集成
- 小结
- 补充参考资料
训练
在前面的部分中,我们讨论了神经网络的静态部分:如何设置网络连接、数据和损失函数。本节专门讨论动力学,或者换句话说,学习参数和找到好的超参数的过程。
梯度检查
理论上,执行梯度检查就像将解析梯度与数值梯度进行比较一样简单。在实践中,这个过程更加复杂并且容易出错。以下是一些需要注意的提示、技巧和问题:
使用居中公式。在评估数值梯度时,您可能见过的有限差分近似公式如下:
$$ \frac{df(x)}{dx} = \frac{f(x + h) - f(x)}{h} \hspace{0.1in} \text{(bad, do not use)} $$
其中 \\(h\\) 是一个非常小的数字,实际上大约为 1e-5 左右。在实践中,事实证明,使用以下形式的居中差分公式要好得多:
$$ \frac{df(x)}{dx} = \frac{f(x + h) - f(x - h)}{2h} \hspace{0.1in} \text{(use instead)} $$
这需要您对损失函数进行两次评估,以检查梯度的每个维度(因此代价大约是原来的两倍),但梯度近似结果要精确得多。要看到这一点,您可以使用 \\(f(x+h)\\) 和 \\(f(x-h)\\) 的泰勒展开,并验证第一个公式在 \\(O(h)\\) 阶上有错误,而第二个公式仅具有 \\(O(h^2)\\) 阶上的误差项(即,它是二阶近似)。
使用相对误差进行比较。比较数值梯度 \\(f'_n\\) 和解析梯度 \\(f'_a\\) 的细节是什么?也就是说,我们怎么知道两者不兼容呢?您可能会想要跟踪差异 \\(\mid f'_a - f'_n \mid \\) 或其平方,并在该差异高于阈值时将梯度检查定义为失败。然而,这是有问题的。例如,考虑它们的差为 1e-4 的情况。如果两个梯度约为 1.0,这似乎是一个非常合适的差异,因此我们会考虑匹配两个梯度。但如果梯度都在 1e-5 或更低的量级上,那么我们会认为 1e-4 存在巨大差异,并且可能会失败。因此,考虑相对误差总是更合适:
$$ \frac{\mid f'_a - f'_n \mid}{\max(\mid f'_a \mid, \mid f'_n \mid)} $$
它考虑了它们的差值与两个梯度的绝对值之比。请注意,通常相对误差公式仅包含两项中的一项(任意一项),但我更喜欢将两项都取最大值(或相加),以使其对称并防止在两项之一为零的情况下除以零(这种情况经常发生,尤其是使用 ReLU)。然而,必须明确地跟踪两者都为零的情况,并通过该边缘情况下的梯度检查。在实践中:
- 相对误差 > 1e-2 通常意味着梯度可能是错误的
- 1e-2 > 相对误差 > 1e-4 应该会让你感觉不舒服
- 对于存在不可导拐点的目标函数,相对误差小于 1e-4 通常可以接受。但若目标处处光滑,例如使用 tanh 和 Softmax,则 1e-4 仍然偏大。
- 1e-7 或更少你应该感到高兴。
另请记住,网络越深,相对误差就越高。因此,如果您对 10 层网络的输入数据进行梯度检查,1e-2 的相对误差可能是可以接受的,因为误差会在此过程中累积。相反,单个可微函数的 1e-2 误差可能表示梯度不正确。
使用双精度。一个常见的陷阱是使用单精度浮点来计算梯度检查。通常情况下,即使使用正确的梯度实现,您也可能会得到较高的相对误差(高达 1e-2)。根据我的经验,有时通过切换到双精度,我的相对误差会从 1e-2 骤降至 1e-8。
坚持浮点的有效范围。最好通读“每个计算机科学家都应该了解浮点运算”,因为它可能会揭开您的错误的神秘面纱,并使您能够编写更仔细的代码。例如,在神经网络中,通常会对批量的损失函数进行标准化。但是,如果每个数据点的梯度非常小,那么另外将它们除以数据点的数量将开始给出非常小的数字,这反过来会导致更多的数值问题。这就是为什么我喜欢总是打印原始数值/解析梯度,并确保您要比较的数字不是非常小(例如,大约 1e-10 且绝对值更小令人担忧)。如果是这样,您可能需要暂时将损失函数扩大一个常数,以使它们达到“更好”的范围,其中浮点数更密集 - 理想情况下约为 1.0,其中浮点指数为 0。
目标函数的不可导拐点。在梯度检查过程中需要注意的不准确性的来源之一是不可导拐点问题。不可导拐点是指目标函数的不可微分部分,由 ReLU (\\(max(0,x)\\)) 或 SVM 损失、Maxout 神经元等函数引入。考虑在 \\(x = -1e6\\) 处对 ReLU 函数进行梯度检查。由于 \\(x < 0\\),此时的解析梯度恰好为零。然而,数值梯度会突然计算出非零梯度,因为 \\(f(x+h)\\) 可能会跨越不可导拐点(例如,如果 \\(h > 1e-6\\))并引入非零贡献。你可能认为这是一个特殊的极端情况,但事实上这种情况很常见。例如,CIFAR-10 的 SVM 最多包含 450,000 个 \\(max(0,x)\\) 项,因为有 50,000 个示例,每个示例生成 9 个目标项。此外,由于 ReLU,带有 SVM 分类器的神经网络将包含更多的不可导拐点。
请注意,可以知道在损失评估中是否交叉了不可导拐点。这可以通过以 \\(max(x,y)\\) 形式的函数跟踪所有“获胜者”的身份来完成;也就是说,在前向传播过程中 x 或 y 更高。如果在评估 \\(f(x+h)\\) 然后评估 \\(f(x-h)\\) 时至少一名获胜者的身份发生变化,则出现了不可导拐点,并且数值梯度将不准确。
仅使用少量数据点。解决上述不可导拐点问题的一种方法是使用更少的数据点,因为包含不可导拐点的损失函数(例如,由于使用 ReLU 或间隔损失等)将在数据点较少的情况下产生更少的不可导拐点,因此当您执行有限差分近似时,您不太可能交叉。此外,如果您仅对大约 2 或 3 个数据点进行 gradcheck,那么您几乎肯定会对整个批次进行 gradcheck。使用很少的数据点还可以使梯度检查更快、更高效。
注意步长 h。不一定越小越好,因为当 \\(h\\) 更小时,您可能会开始遇到数值精度问题。有时,当梯度未检查时,您可能将 \\(h\\) 更改为 1e-4 或 1e-6,突然梯度就正确了。这篇维基百科文章包含一个图表,该图表在 x 轴上绘制了 h 值,在 y 轴上绘制了数值梯度误差。
在“特征”操作模式下进行梯度检查。重要的是要认识到梯度检查是在参数空间中的特定(通常是随机的)单点上执行的。即使此时梯度检查成功,也不能立即确定梯度是否在全局范围内正确实现。此外,随机初始化可能不是参数空间中最具“特征”的点,并且实际上可能会引入病态情况,其中梯度似乎已正确实现,但实际上并非如此。例如,权重初始化非常小的 SVM 将为所有数据点分配几乎为零的分数,并且梯度将在所有数据点上表现出特定的模式。梯度的不正确实现仍然可能产生这种模式,并且不能推广到更具特征的操作模式,其中某些分数比其他分数大。因此,为了安全起见,最好使用较短的burn-in时间,在此期间允许网络在损失开始下降后学习并执行梯度检查。在第一次迭代时执行它的危险在于,这可能会引入病态的边缘情况并掩盖梯度的错误实现。
不要让正则化淹没数据。通常情况下,损失函数是数据损失和正则化损失的总和(例如权重的 L2 惩罚)。需要注意的一个危险是正则化损失可能会压倒数据损失,在这种情况下,梯度将主要来自正则化项(通常具有更简单的梯度表达式)。这可以掩盖数据损失梯度的错误实现。因此,建议关闭正则化并首先单独检查数据损失,然后再独立检查正则化项。执行后者的一种方法是破解代码以消除数据损失的影响。另一种方法是增加正则化强度,以确保其影响在梯度检查中不可忽略,并且能够发现不正确的实现。
记住关闭 dropout/augmentations。执行梯度检查时,请记住关闭网络中的任何非确定性效应,例如Dropout、随机数据增强等。否则,在估计数值梯度时,这些可能会明显引入巨大的误差。关闭这些效果的缺点是您不会对它们进行梯度检查(例如,dropout 可能没有正确反向传播)。因此,更好的解决方案可能是在评估 \\(f(x+h)\\) 和 \\(f(x-h)\\) 之前以及评估解析梯度时强制使用特定的随机种子。
仅检查少数维度。实际上,梯度的大小可以有百万个参数。在这些情况下,只实际检查梯度的某些维度并假设其他维度是正确的。 要小心:需要注意的一个问题是确保对每个单独参数的几个维度进行梯度检查。在某些应用中,为了方便起见,人们将参数组合成单个大参数向量。例如,在这些情况下,偏差只能占用整个向量中的一小部分参数,因此重要的是不要随机采样,而是要考虑到这一点并检查所有参数是否都接收到正确的梯度。
训练前:基本正确性检查与实用技巧
在进行昂贵的优化之前,您可能会考虑运行以下一些基本正确性检查:
- 寻找随机性能的正确损失。确保在使用小参数初始化时获得预期的损失。最好首先单独检查数据损失(因此将正则化强度设置为零)。例如,对于具有 Softmax 分类器的 CIFAR-10,我们预计初始损失为 2.302,因为我们预计每个类别的扩散概率为 0.1(因为有 10 个类别),而 Softmax 损失是正确类别的负对数概率,因此:-ln(0.1) = 2.302。对于 Weston Watkins SVM,我们预计所有期望的间隔都会被违反(因为所有分数大约为零),因此预计损失为 9(因为每个错误类别的间隔为 1)。如果您没有看到这些损失,则初始化可能存在问题。
- 作为第二次基本正确性检查,增加正则化强度应该会增加损失
- 过拟合一小部分数据。最后也是最重要的是,在对完整数据集进行训练之前,尝试对数据的一小部分(例如 20 个示例)进行训练,并确保可以实现零代价。对于此实验,最好将正则化设置为零,否则这会阻止您获得零代价。除非您使用小数据集通过了基本正确性检查,否则不值得继续处理完整数据集。请注意,您可能会过拟合非常小的数据集,但仍然有不正确的实现。例如,如果您的数据点的特征由于某些错误而随机,那么您的小型训练集可能会过拟合,但当您将其扩展到完整数据集时,您永远无法获得泛化能力。
监控训练过程
在神经网络训练期间,您应该监控多个有用的量。这些图是训练过程的窗口,应该用来直观地了解不同的超参数设置以及如何更改它们以实现更有效的学习。
下图的 x 轴始终以 epoch 为单位,它衡量每个示例在预期训练期间被看到的次数(例如,一个 epoch 意味着每个示例都被看到一次)。最好跟踪纪元而不是迭代,因为迭代次数取决于批量大小的任意设置。
损失函数
在训练期间跟踪的第一个有用的量是损失,因为它是在前向传播期间对各个批次进行评估的。下面是一张卡通图,显示了随时间变化的损失,特别是形状可以告诉您有关学习率的信息:
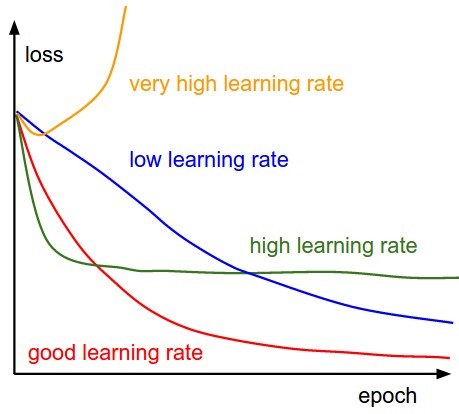
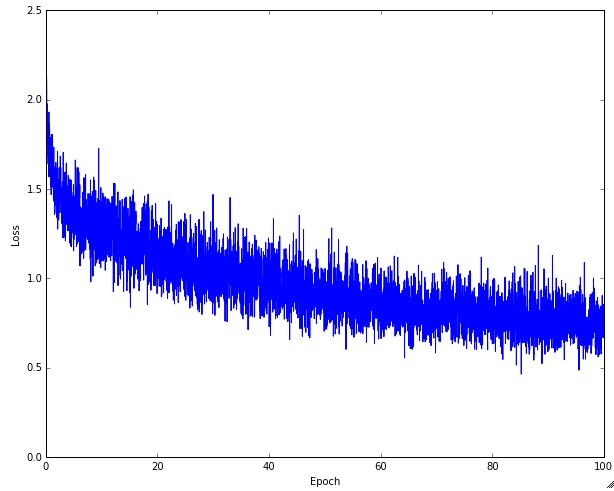
损失中的“摆动”量与批量大小有关。当批量大小为1时,摆动会相对较高。当批量大小是完整数据集时,摆动将是最小的,因为每次梯度更新都应该单调地改进损失函数(除非学习率设置得太高)。
有些人喜欢在对数域中绘制损失函数。由于学习进度通常呈指数形式,因此该图显示为更容易解释的直线,而不是曲棍球棒。此外,如果在同一个损失图上绘制多个交叉验证模型,它们之间的差异就会变得更加明显。
有时损失函数可能看起来很有趣lossfunctions.tumblr.com。
训练/验证准确率
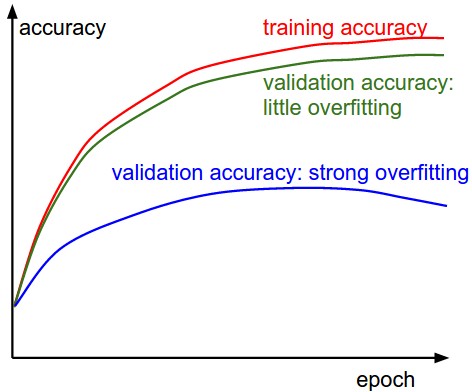
训练分类器时要跟踪的第二个重要量是验证/训练准确性。该图可以让您深入了解模型中的过拟合量:
权重比:更新
您可能想要跟踪的最后一个量是更新幅度与值幅度的比率。注意:更新,而不是原始梯度(例如,在普通 sgd 中,这将是梯度乘以学习率)。您可能想要独立评估和跟踪每组参数的该比率。一个粗略的启发是,这个比率应该在 1e-3 左右。如果低于此值,则学习率可能太低。如果它较高,则学习率可能太高。下面是一个具体的例子:
# assume parameter vector W and its gradient vector dW
param_scale = np.linalg.norm(W.ravel())
update = -learning_rate*dW # simple SGD update
update_scale = np.linalg.norm(update.ravel())
W += update # the actual update
print update_scale / param_scale # want ~1e-3
有些人不喜欢跟踪最小值或最大值,而是更喜欢计算和跟踪梯度的范数及其更新。这些指标通常是相关的,并且通常会给出大致相同的结果。
每层的激活/梯度分布
不正确的初始化会减慢甚至完全停止学习过程。幸运的是,这个问题可以相对容易地诊断出来。一种方法是绘制网络所有层的激活/梯度直方图。直观上,看到任何奇怪的分布并不是一个好兆头 - 例如对于 tanh 神经元,我们希望看到神经元激活在整个范围 [-1,1] 之间的分布,而不是看到所有神经元输出零,或者所有神经元在 -1 或 1 处完全饱和。
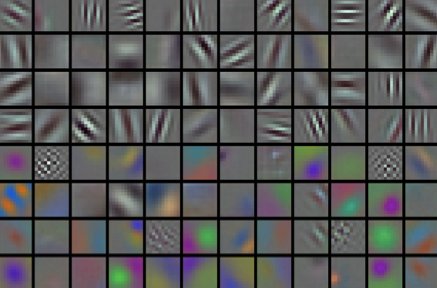
第一层可视化
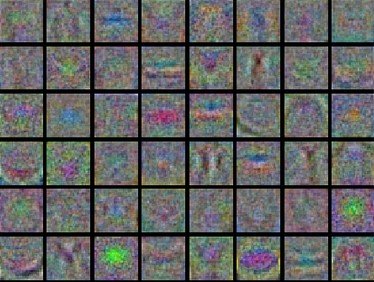
最后,当人们处理图像像素时,直观地绘制第一层特征会很有帮助并且令人满意:
参数更新
一旦通过反向传播计算出解析梯度,梯度就用于执行参数更新。有多种执行更新的方法,我们将在接下来讨论。
我们注意到,深度网络的优化目前是一个非常活跃的研究领域。在本节中,我们将重点介绍您在实践中可能会看到的一些已建立的常见技术,简要描述它们的直觉,但在课程范围之外进行详细分析。我们为感兴趣的读者提供了一些进一步的指导。
新元和附加功能
原版更新。最简单的更新形式是沿着负梯度方向改变参数(因为梯度表示增加的方向,但我们通常希望最小化损失函数)。假设参数向量 x 和梯度 dx,最简单的更新具有以下形式:
# Vanilla update
x += - learning_rate * dx
其中 learning_rate 是一个超参数 - 一个固定常数。当对完整数据集进行评估时,并且当学习率足够低时,可以保证损失函数取得非负进展。
动量更新是另一种在深度网络上几乎总是享有更好收敛率的方法。这种更新可以从优化问题的物理角度出发。特别是,损失可以解释为丘陵地形的高度(因此也解释为自 \\(U = mgh\\) 和 \\( U \propto h \\) 以来的势能)。用随机数初始化参数相当于在某个位置设置一个初速度为零的粒子。优化过程可以被视为等效于模拟参数向量(即粒子)在景观上滚动的过程。
由于粒子所受的力与势能梯度(即 \\(F = - \nabla U \\) )有关,因此粒子感受到的力正是损失函数的(负)梯度。此外,\\(F = ma \\) 因此(负)梯度在此视图中与粒子的加速度成正比。请注意,这与上面所示的 SGD 更新不同,其中梯度直接对位置进行积分。相反,物理视图建议进行更新,其中梯度仅直接影响速度,进而影响位置:
# Momentum update
v = mu * v - learning_rate * dx # integrate velocity
x += v # integrate position
这里引入了初始化为 0 的变量 v,以及额外的超参数 mu。后者在优化中通常称为动量,典型取值约为 0.9;不过从物理意义上看,这一名称不太准确,它更接近摩擦系数。该参数使速度衰减、减少系统动能,否则粒子会在谷底附近持续运动而无法停下。交叉验证时,常尝试 [0.5, 0.9, 0.95, 0.99] 等取值。与后文的学习率退火类似,训练后期逐渐增大动量有时也会改善优化效果。一种常见设置是从约 0.5 开始,在若干个训练轮次内逐渐调到约 0.99。
通过动量更新,参数向量将在具有一致梯度的任何方向上建立速度。
Nesterov Momentum 是最近流行的动量更新的一个略有不同的版本。它对凸函数具有更强的理论收敛保证,并且在实践中它也始终比标准动量稍好一些。
Nesterov动量背后的核心思想是,当当前参数向量处于某个位置x时,然后查看上面的动量更新,我们知道单独的动量项(即忽略带有梯度的第二项)即将参数向量微移mu * v。因此,如果我们要计算梯度,我们可以将未来的近似位置 x + mu * v 视为“前瞻” - 这是我们即将结束的位置附近的点。因此,计算 x + mu * v 处的梯度而不是“旧/陈旧”位置 x 处的梯度是有意义的。
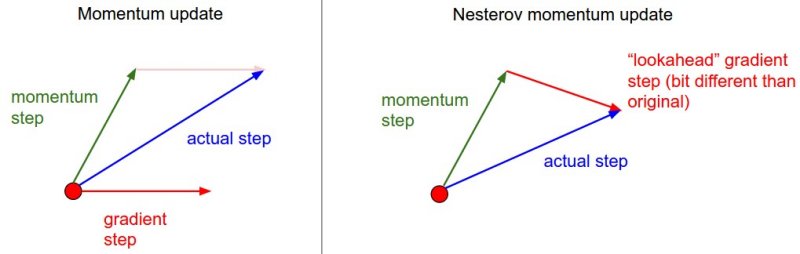
也就是说,用一种有点尴尬的表示法,我们想要执行以下操作:
x_ahead = x + mu * v
# evaluate dx_ahead (the gradient at x_ahead instead of at x)
v = mu * v - learning_rate * dx_ahead
x += v
然而,实际上,人们更喜欢将更新表达为尽可能类似于普通 SGD 或之前的动量更新。这可以通过使用变量变换 x_ahead = x + mu * v 操作上面的更新,然后用 x_ahead 而不是 x 来表达更新来实现。也就是说,我们实际存储的参数向量始终是前面的版本。以 x_ahead 表示的方程(但将其重命名回 x)则变为:
v_prev = v # back this up
v = mu * v - learning_rate * dx # velocity update stays the same
x += -mu * v_prev + (1 + mu) * v # position update changes form
我们建议进一步阅读此内容,以了解这些方程的来源以及涅斯特洛夫加速动量 (NAG) 的数学公式:
- Yoshua Bengio 的优化循环网络的进展,第 3.5 节。
- Ilya Sutskever 的论文 (pdf) 在第 7.2 节中包含对该主题的较长阐述
学习率退火
在训练深度网络时,随着时间的推移对学习率进行退火通常很有帮助。需要牢记的良好直觉是,在高学习率的情况下,系统包含过多的动能,参数向量会混乱地反弹,无法稳定在损失函数的更深但更窄的部分。知道何时衰减学习率可能很棘手:缓慢地衰减它,你将在很长一段时间内浪费计算量,混乱地弹跳而几乎没有任何改进。但如果衰减得太剧烈,系统就会冷却得太快,无法达到最佳位置。实现学习率衰减的常见类型有以下三种:
- 分段衰减:每训练若干轮,就将学习率乘以一个衰减系数。例如每 5 轮乘以 0.5,或每 20 轮乘以 0.1。具体轮数和系数高度依赖任务与模型。一种常见做法是以固定学习率训练并观察验证集误差;当误差不再改善时,将学习率乘以某个常数,例如 0.5。
- 指数衰减。 具有数学形式 \\(\alpha = \alpha_0 e^{-k t}\\),其中 \\(\alpha_0, k\\) 是超参数,\\(t\\) 是迭代次数(但您也可以使用纪元单位)。
- 1/t 衰减 具有数学形式 \\(\alpha = \alpha_0 / (1 + k t )\\),其中 \\(a_0, k\\) 是超参数,\\(t\\) 是迭代次数。
在实践中,我们发现步进衰减稍微更可取,因为它涉及的超参数(衰减分数和以纪元为单位的步进计时)比超参数 \\(k\\) 更容易解释。最后,如果您能负担得起计算预算,最好选择较慢的衰减并训练较长的时间。
二阶方法
深度学习背景下第二组流行的优化方法基于牛顿法,它迭代以下更新:
$$ x \leftarrow x - [H f(x)]^{-1} \nabla f(x) $$
这里,\\(H f(x)\\) 是Hessian 矩阵,它是函数二阶偏导数的方阵。 \\(\nabla f(x)\\) 项是梯度向量,如梯度下降中所示。直观上,Hessian 矩阵描述了损失函数的局部曲率,这使我们能够执行更有效的更新。特别是,乘以逆 Hessian 矩阵会导致优化在浅曲率方向上采取更积极的步骤,并在陡曲率方向上采取更短的步骤。请注意,至关重要的是,更新公式中没有任何学习率超参数,这些方法的支持者认为这是相对于一阶方法的一大优势。
然而,上述更新对于大多数深度学习应用来说是不切实际的,因为以显式形式计算(和反转)Hessian 矩阵在空间和时间上都是一个非常昂贵的过程。例如,具有一百万个参数的神经网络将具有大小为 [1,000,000 x 1,000,000] 的 Hessian 矩阵,占用大约 3725 GB 的 RAM。因此,人们开发了多种拟牛顿方法来寻求近似逆 Hessian 矩阵。其中,最流行的是 L-BFGS,它使用随时间变化的梯度信息来隐式形成近似值(即从不计算完整矩阵)。
然而,即使我们消除了内存问题,L-BFGS 的简单应用的一个很大的缺点是它必须在整个训练集上进行计算,其中可能包含数百万个示例。与小批量 SGD 不同,让 L-BFGS 在小批量上工作更加棘手,也是一个活跃的研究领域。
在实践中,目前 L-BFGS 或类似的二阶方法应用于大规模深度学习和卷积神经网络的情况并不常见。相反,基于(Nesterov)动量的 SGD 变体更加标准,因为它们更简单并且更容易扩展。
附加参考:
- 大规模分布式深度网络是 Google Brain 团队的一篇论文,比较了大规模分布式优化中的 L-BFGS 和 SGD 变体。
- SFO算法力求将SGD的优点与L-BFGS的优点结合起来。
每参数自适应学习率方法
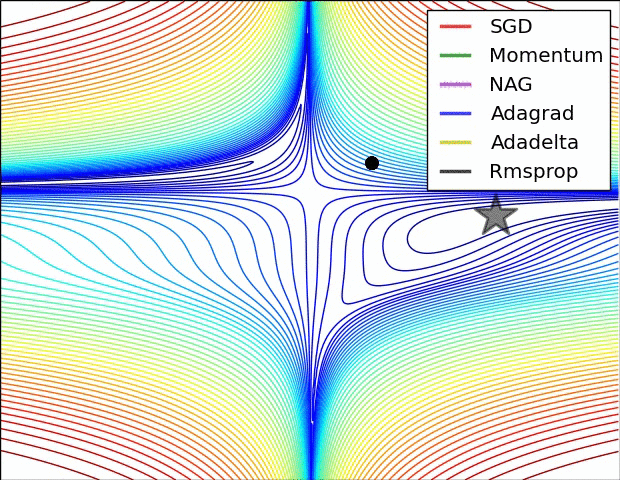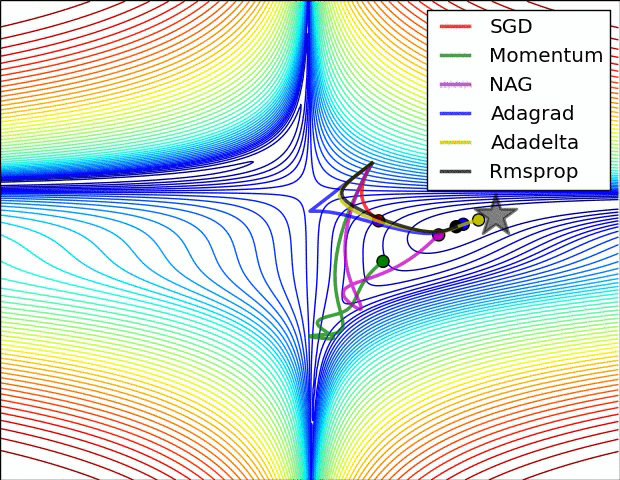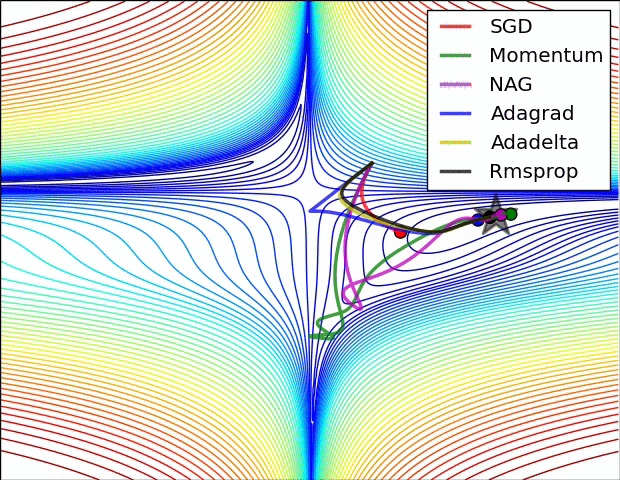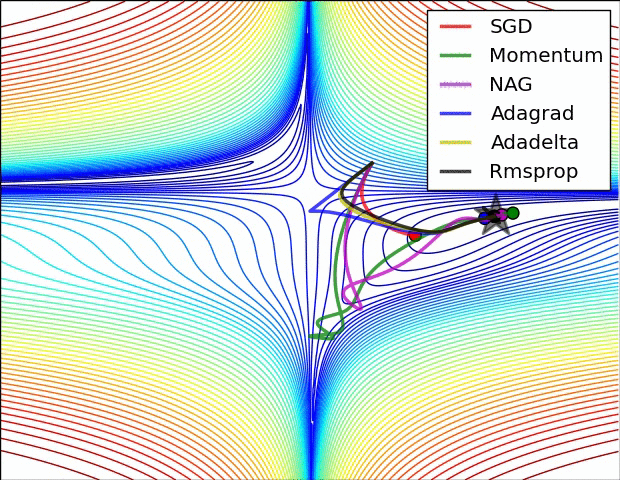
到目前为止,我们讨论的所有先前方法都是全局且平等地操纵所有参数的学习率。调整学习率是一个昂贵的过程,因此我们投入了大量的工作来设计可以自适应调整学习率的方法,甚至可以针对每个参数进行调整。其中许多方法可能仍然需要其他超参数设置,但争论是,它们对于比原始学习率更广泛的超参数值表现良好。在本节中,我们重点介绍您在实践中可能遇到的一些常见自适应方法:
Adagrad是一种自适应学习率方法,最初由Duchi等人提出。
# Assume the gradient dx and parameter vector x
cache += dx**2
x += - learning_rate * dx / (np.sqrt(cache) + eps)
请注意,变量 cache 的大小等于梯度的大小,并跟踪每个参数的梯度平方和。然后将其用于按元素标准化参数更新步骤。请注意,接收高梯度的权重将降低其有效学习率,而接收小或不频繁更新的权重将提高其有效学习率。有趣的是,平方根运算非常重要,如果没有它,算法的性能会更差。平滑项 eps(通常设置在 1e-4 到 1e-8 范围内)避免被零除。 Adagrad 的一个缺点是,在深度学习中,学习率的单调衰减通常过于激进并且过早停止学习。
RMSprop。 RMSprop 是一种非常有效、但目前尚未发布的自适应学习率方法。有趣的是,目前在工作中使用此方法的每个人都引用了 Geoff Hinton 的 Coursera 课程的第 6 讲的幻灯片 29。 RMSProp 更新以一种非常简单的方式调整 Adagrad 方法,试图降低其激进的、单调递减的学习率。特别是,它使用梯度平方的移动平均值来代替,给出:
cache = decay_rate * cache + (1 - decay_rate) * dx**2
x += - learning_rate * dx / (np.sqrt(cache) + eps)
这里,decay_rate 是超参数,常见取值为 [0.9, 0.99, 0.999]。x+= 的更新形式与 Adagrad 相同,但 cache 不再无限累加,而会逐渐衰减旧梯度的贡献。因此,RMSProp 仍会根据梯度幅值调整各权重的学习率,起到平衡不同参数更新幅度的作用;同时避免了 Adagrad 的更新幅度持续单调减小的问题。
Adam。 Adam 是最近提出的更新,看起来有点像带有动量的 RMSProp。 (简化的)更新如下所示:
m = beta1*m + (1-beta1)*dx
v = beta2*v + (1-beta2)*(dx**2)
x += - learning_rate * m / (np.sqrt(v) + eps)
这种更新与 RMSProp 很相似,区别在于用平滑后的梯度 m,替代可能含有较大噪声的原始梯度 dx。论文推荐 eps = 1e-8、beta1 = 0.9、beta2 = 0.999。原文建议将 Adam 作为默认选择,它通常略优于 RMSProp;同时也值得尝试 SGD 加 Nesterov 动量。完整的 Adam 还包含偏差校正:由于向量 m,v 初始化为零,最初几个时间步的估计会偏向零,校正用于补偿这一影响。加入偏差校正后的更新如下:
# t is your iteration counter going from 1 to infinity
m = beta1*m + (1-beta1)*dx
mt = m / (1-beta1**t)
v = beta2*v + (1-beta2)*(dx**2)
vt = v / (1-beta2**t)
x += - learning_rate * mt / (np.sqrt(vt) + eps)
请注意,更新现在是迭代以及其他参数的函数。 我们建议读者参阅论文以了解详细信息,或者参阅扩展此内容的课程幻灯片。
附加参考资料:
- 随机优化的单元测试提出了一系列测试作为随机优化的标准化基准。

超参数优化
正如我们所见,训练神经网络可能涉及许多超参数设置。神经网络中最常见的超参数包括:
- 初始学习率
- 学习率衰减时间表(例如衰减常数)
- 正则化强度(L2惩罚、dropout强度)
但正如我们所看到的,还有许多相对不太敏感的超参数,例如在每个参数的自适应学习方法中,动量的设置及其时间表等。在本节中,我们将描述一些用于执行超参数搜索的额外提示和技巧:
实现方式。较大的神经网络训练耗时很长,因此超参数搜索可能持续数天甚至数周,设计程序时应考虑这一点。一种做法是使用工作进程(worker),不断随机采样超参数并训练模型。每个训练轮次结束后,记录验证集表现,将模型检查点及损失变化等训练统计写入文件,最好保存在共享文件系统中。把验证结果直接写入文件名,便于检查和排序。另设一个主控进程(master),在计算集群上启动或终止工作进程,也可以读取检查点并绘制训练统计。
首选一次验证折而不是交叉验证。在大多数情况下,单个验证集的大小相当大,可以大大简化代码库,而不需要进行多次折的交叉验证。您会听到人们说他们“交叉验证”了一个参数,但很多时候假设他们仍然只使用单个验证集。
超参数的搜索范围。学习率等超参数应在对数尺度上搜索。例如 learning_rate = 10 ** uniform(-6, 1):先均匀采样指数,再计算 10 的该指数次幂。正则化强度也适用这种方式。这是因为它们对训练过程产生的是乘法尺度上的影响:学习率为 0.001 时,增加 0.01 会显著改变更新幅度;学习率为 10 时,同样增加 0.01 的影响却很小。学习率直接乘在梯度上,所以按倍数放大或缩小它,比加减固定值更自然。另一些超参数,例如 Dropout 的概率,通常直接在原始尺度上搜索,如 dropout = uniform(0,1)。
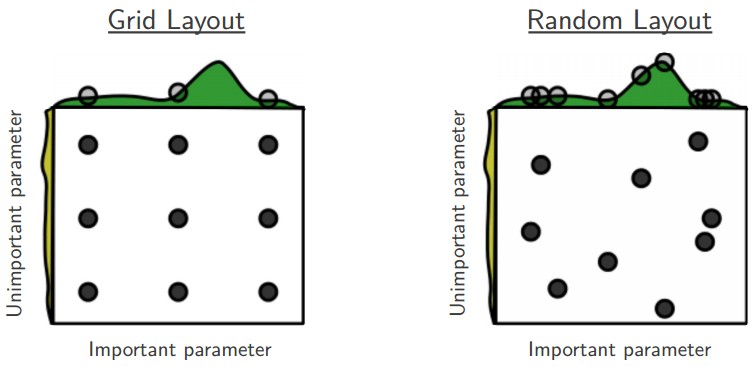
喜欢随机搜索而不是网格搜索。正如 Bergstra 和 Bengio 在超参数优化的随机搜索中所说,“对于超参数优化,随机选择的试验比网格上的试验更有效”。事实证明,这通常也更容易实现。
注意边界上的最佳值。有时,您可能会在错误的范围内搜索超参数(例如学习率)。例如,假设我们使用 learning_rate = 10 ** uniform(-6, 1)。一旦我们收到结果,请务必仔细检查最终学习率是否不在该区间的边缘,否则您可能会错过该区间之外的更优化的超参数设置。
按从粗略到精细的顺序进行搜索。在实践中,首先在粗范围内搜索(例如 10 ** [-6, 1]),然后根据最佳结果出现的位置缩小范围会很有帮助。此外,在仅训练 1 个 epoch 甚至更少的情况下执行初始粗略搜索也很有帮助,因为许多超参数设置可能导致模型根本无法学习,或者立即以无限代价爆炸。然后,第二阶段可以执行 5 个轮次的更窄搜索,最后一个阶段可以在最终范围内执行更多轮次的详细搜索(例如)。
贝叶斯超参数优化是一个完整的研究领域,致力于提出尝试更有效地导航超参数空间的算法。核心思想是在查询不同超参数下的性能时适当平衡探索-利用权衡。基于这些模型也开发了多个库,其中一些较知名的库包括 Spearmint、SMAC 和 Hyperopt。然而,在卷积网络的实际设置中,在仔细选择的搜索区间内优于随机搜索仍然相对困难。请参阅此处的一些额外现场讨论。
评估
模型集成
在实践中,将神经网络性能提高几个百分点的一种可靠方法是训练多个独立模型,并在测试时对它们的预测进行平均。随着集成中模型数量的增加,性能通常会单调提高(尽管收益递减)。此外,随着集成中模型种类的增加,改进会更加显着。有几种形成集成的方法:
- 相同模型,不同初始化。使用交叉验证来确定最佳超参数,然后使用最佳超参数集但具有不同的随机初始化来训练多个模型。这种方法的危险在于变化仅是由于初始化造成的。
- 交叉验证期间发现的热门模型。使用交叉验证来确定最佳超参数,然后选择前几个(例如 10 个)模型来形成整体。这提高了集成的多样性,但存在包含次优模型的危险。在实践中,这可以更容易执行,因为它不需要在交叉验证后对模型进行额外的重新训练
- 单个模型的不同检查点。如果训练非常昂贵,那么有些人在随着时间的推移(例如在每个轮次之后)采取单个网络的不同检查点并使用这些检查点形成整体方面取得的成功有限。显然,这缺乏多样性,但在实践中仍然可以很好地发挥作用。这种方法的优点是非常便宜。
- 训练期间参数的运行平均值。与最后一点相关,几乎总能获得额外百分之一或百分之二的性能的一种廉价方法是在内存中维护网络权重的第二个副本,该副本在训练期间维持先前权重的指数衰减总和。通过这种方式,您可以对最近几次迭代中的网络状态进行平均。您会发现,最后几个步骤中权重的“平滑”版本几乎总是能实现更好的验证误差。要记住的粗略直觉是,目标是碗形的,并且您的网络在模式周围跳跃,因此平均值更有可能接近模式。
模型集成的一个缺点是它们需要更长的时间来评估测试示例。感兴趣的读者可能会发现 Geoff Hinton 最近关于“黑暗知识” 的工作很鼓舞人心,其中的想法是通过将集成日志可能性合并到修改后的目标中,将良好的集成“提炼”回单个模型。
小结
训练神经网络:
- 使用一小批数据梯度检查您的实现并注意其中的陷阱。
- 作为基本正确性检查,请确保您的初始损失是合理的,并且您可以在极小部分数据上实现 100% 的训练准确性
- 在训练期间,监视损失、训练/验证准确率,如果您感觉更有趣,还可以监视与参数值相关的更新幅度(应该为 ~1e-3),以及在处理 ConvNet 时,监视第一层权重。
- 建议使用的两个更新是 SGD+Nesterov Momentum 或 Adam。
- 在训练期间降低你的学习率。例如,在固定数量的 epoch 后或每当验证准确率达到最高值时,将学习率减半。
- 通过随机搜索(不是网格搜索)来搜索好的超参数。从粗略(较宽的超参数范围,仅训练 1-5 个轮次)到精细(更窄的范围,训练更多轮次)分阶段进行搜索
- 形成模型整体以获得额外的性能
补充参考资料
- Leon Bottou 的 SGD 提示和技巧
- 高效 BackProp (pdf) 来自 Yann LeCun
- 基于梯度的深度训练的实用建议 Yoshua Bengio 的架构