神经网络(二):数据处理与损失函数
本篇目录:
准备数据与构建模型
在上一节中,我们介绍了一个神经元模型,它计算点积后再施加非线性变换,以及将神经元排列成层的神经网络。这些选择共同定义了得分函数的新形式,我们从线性分类部分中看到的简单线性映射扩展了它。特别是,神经网络执行一系列线性映射与非线性变换交替进行的计算。在本节中,我们将讨论有关数据预处理、权重初始化和损失函数的其他设计选择。
数据预处理
数据矩阵 X 的数据预处理有三种常见形式,其中我们假设 X 的大小为 [N x D](N 是数据的数量,D 是数据的维数)。
均值减法是最常见的预处理形式。它涉及减去数据中每个单独特征的平均值,并具有将数据云沿每个维度以原点为中心的几何解释。在 numpy 中,此操作将实现为:X -= np.mean(X, axis = 0)。特别是对于图像,为了方便起见,通常会从所有像素中减去单个值(例如 X -= np.mean(X)),或者在三个颜色通道中单独执行此操作。
归一化是指对数据维度进行归一化,使它们具有大致相同的规模。有两种常见的方法可以实现这种标准化。一种是以零为中心的方法,将各维度分别除以其标准差:(X /= np.std(X, axis = 0))。此预处理的另一种形式对对各维度进行缩放,以便沿维度的最小值和最大值分别为 -1 和 1。仅当您有理由相信不同的输入特征具有不同的尺度(或单位)时,应用此预处理才有意义,但它们对于学习算法应该具有大致相同的重要性。
对于图像,像素的相对比例已经大致相等(范围从 0 到 255),因此并不严格需要执行此额外的预处理步骤。
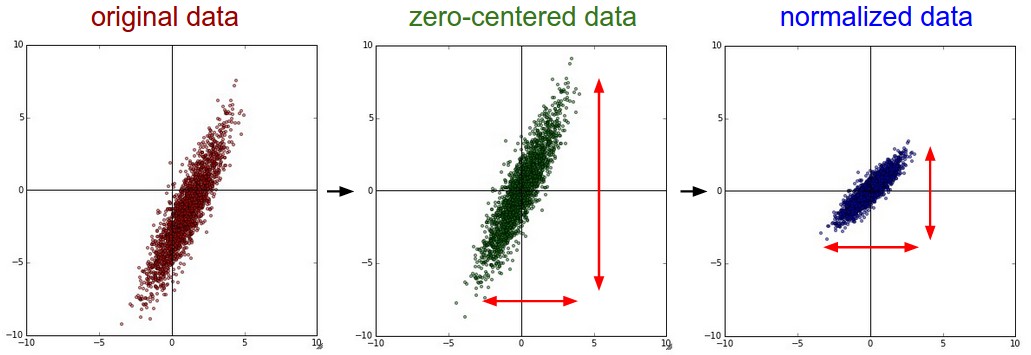
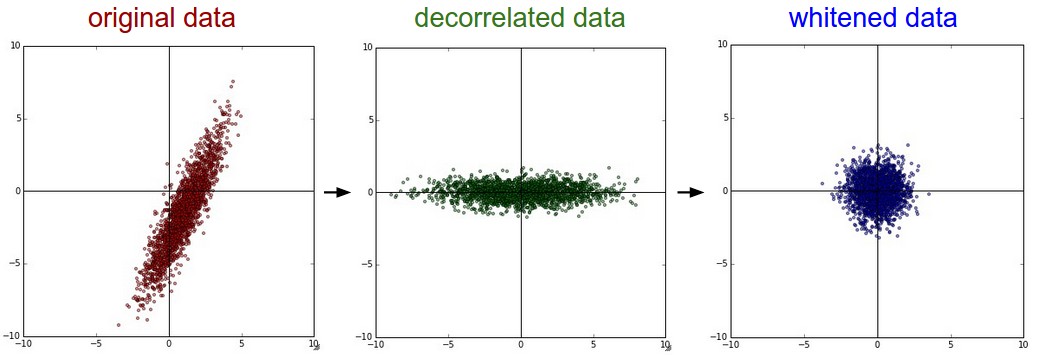
PCA 和白化是另一种形式的预处理。在此过程中,首先如上所述对数据进行居中。然后,我们可以计算协方差矩阵,它告诉我们数据中的相关结构:
# Assume input data matrix X of size [N x D]
X -= np.mean(X, axis = 0) # zero-center the data (important)
cov = np.dot(X.T, X) / X.shape[0] # get the data covariance matrix
数据协方差矩阵的 (i,j) 元素包含数据的第 i 维和第 j 维之间的协方差。特别是,该矩阵的对角线包含方差。此外,协方差矩阵是对称的且正半定。我们可以计算数据协方差矩阵的 SVD 分解:
U,S,V = np.linalg.svd(cov)
其中 U 的列是特征向量,S 是奇异值的一维数组。为了对数据进行去相关,我们将原始(但以零为中心)数据投影到特征基中:
Xrot = np.dot(X, U) # decorrelate the data
请注意,U 的列是一组正交向量(范数为 1,并且彼此正交),因此它们可以被视为基向量。因此,投影对应于 X 中数据的旋转,以便新轴是特征向量。如果我们要计算 Xrot 的协方差矩阵,我们会发现它现在是对角矩阵。 np.linalg.svd 的一个很好的特性是,在其返回值 U 中,特征向量列按其特征值排序。我们可以使用它来减少数据的维度,只使用前几个特征向量,并丢弃数据没有方差的维度。这有时也称为主成分分析 (PCA) 降维:
Xrot_reduced = np.dot(X, U[:,:100]) # Xrot_reduced becomes [N x 100]
在此操作之后,我们会将大小为 [N x D] 的原始数据集减小为大小为 [N x 100] 的数据集,保留包含最大方差的数据的 100 维。通常情况下,通过在 PCA 缩减数据集上训练线性分类器或神经网络,可以获得非常好的性能,从而节省空间和时间。
您在实践中可能看到的最后一个转变是美白。白化操作获取特征基中的数据,并将每个维度除以特征值以标准化尺度。该变换的几何解释是,如果输入数据是多变量高斯分布,则白化数据将是具有零均值和单位协方差矩阵的高斯分布。此步骤将采用以下形式:
# whiten the data:
# divide by the eigenvalues (which are square roots of the singular values)
Xwhite = Xrot / np.sqrt(S + 1e-5)
警告:夸大噪音。请注意,我们添加 1e-5(或一个小常数)以防止被零除。这种转换的一个弱点是它会极大地夸大数据中的噪声,因为它将输入中的所有维度(包括微小方差的不相关维度,主要是噪声)拉伸为相同大小。实际上,这可以通过更强的平滑来缓解(即将 1e-5 增加到更大的数字)。
我们还可以尝试使用 CIFAR-10 图像来可视化这些转换。 CIFAR-10 的训练集大小为 50,000 x 3072,其中每个图像都拉伸为 3072 维的行向量。然后我们可以计算 [3072 x 3072] 协方差矩阵并计算其 SVD 分解(这可能相对昂贵)。计算出的特征向量在视觉上看起来是什么样子?图片可能会有所帮助:
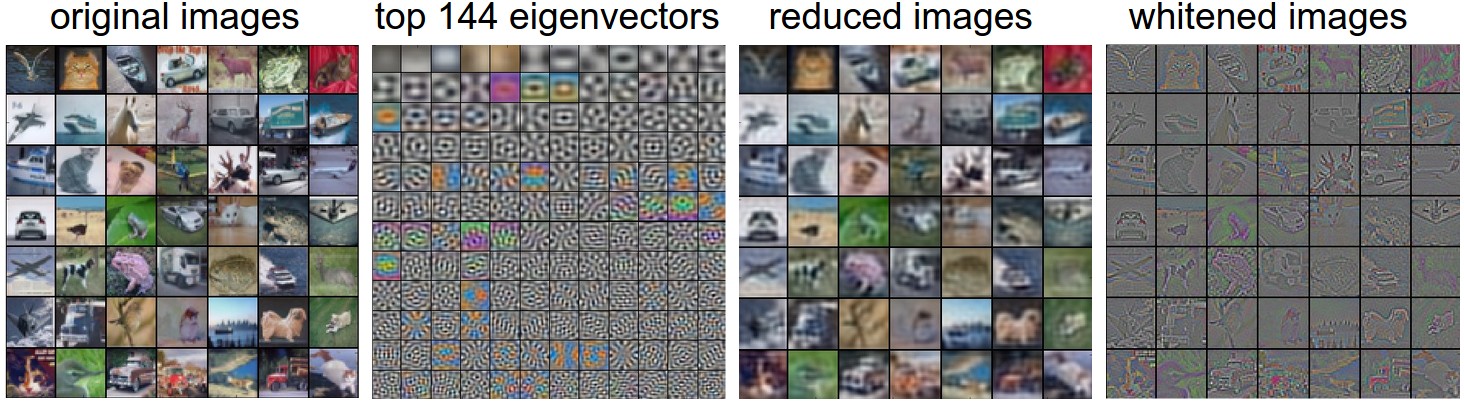
实践中。为了完整性,我们在这些注释中提到了 PCA/白化,但这些转换不与卷积网络一起使用。然而,对数据进行零中心化非常重要,并且每个像素的归一化也很常见。
常见陷阱。关于预处理需要注意的重要一点是,任何预处理统计数据(例如数据平均值)必须仅在训练数据上计算,然后应用于验证/测试数据。例如。计算平均值并从整个数据集中的每个图像中减去它,然后将数据分割为训练集、验证集和测试集将是一个错误。相反,必须仅根据训练数据计算平均值,然后从训练集、验证集和测试集的数据中分别减去这个均值。
权重初始化
我们已经了解了如何构建神经网络架构以及如何预处理数据。在开始训练网络之前,我们必须初始化其参数。
陷阱:全零初始化。让我们从我们不应该做的事情开始。请注意,我们不知道训练网络中每个权重的最终值应该是多少,但通过适当的数据标准化,可以合理地假设大约一半的权重为正,一半为负。一个听起来合理的想法可能是将所有初始权重设置为零,我们期望这是期望中的“最佳猜测”。事实证明这是一个错误,因为如果网络中的每个神经元计算相同的输出,那么它们也将在反向传播期间计算相同的梯度并经历完全相同的参数更新。换句话说,如果神经元的权重被初始化为相同,那么神经元之间就不存在不对称的根源。
小随机数。因此,我们仍然希望权重非常接近于零,但正如我们上面所讨论的,并不完全为零。作为一种解决方案,通常将神经元的权重初始化为较小的数字,并将这样做称为对称性破缺。这个想法是,神经元在开始时都是随机且独特的,因此它们将计算不同的更新并将自己整合为整个网络的不同部分。一个权重矩阵的实现可能类似于 W = 0.01* np.random.randn(D,H),其中 randn 从零均值、单位标准差高斯中采样。通过这个公式,每个神经元的权重向量被初始化为从多维高斯采样的随机向量,因此神经元指向输入空间中的随机方向。也可以使用从均匀分布中抽取的小数,但这似乎对实践中的最终性能影响相对较小。
警告:数字越小并不一定效果越好。例如,具有非常小的权重的神经网络层将在反向传播期间计算其数据上非常小的梯度(因为该梯度与权重的值成比例)。这可能会大大减少通过网络反向流动的“梯度信号”,并可能成为深度网络的一个问题。
使用 1/sqrt(n) 校准方差。上述建议的一个问题是,随机初始化的神经元的输出分布的方差随着输入数量的增加而增长。事实证明,我们可以通过将每个神经元的权重向量按其 fan-in(即其输入数量)的平方根进行缩放,将每个神经元输出的方差归一化为 1。也就是说,推荐的启发式是将每个神经元的权重向量初始化为:w = np.random.randn(n) / sqrt(n),其中n是其输入的数量。这确保了网络中的所有神经元最初具有大致相同的输出分布,并根据经验提高了收敛速度。
推导的草图如下:考虑权重 \\(w\\) 和输入 \\(x\\) 之间的内积 \\(s = \sum_i^n w_i x_i\\),它给出了非线性之前神经元的原始激活。我们可以检查 \\(s\\) 的方差:
$$ \begin{align} \text{Var}(s) &= \text{Var}(\sum_i^n w_ix_i) \\\\ &= \sum_i^n \text{Var}(w_ix_i) \\\\ &= \sum_i^n [E(w_i)]^2\text{Var}(x_i) + [E(x_i)]^2\text{Var}(w_i) + \text{Var}(x_i)\text{Var}(w_i) \\\\ &= \sum_i^n \text{Var}(x_i)\text{Var}(w_i) \\\\ &= \left( n \text{Var}(w) \right) \text{Var}(x) \end{align} $$
在前 2 个步骤中,我们使用了方差的性质。在第三步中,我们假设输入和权重均值为零,因此 \\(E[x_i] = E[w_i] = 0\\)。请注意,通常情况并非如此:例如 ReLU 单位将具有正均值。在最后一步中,我们假设所有 \\(w_i, x_i\\) 都是同分布的。从这个推导我们可以看出,如果我们希望 \\(s\\) 与其所有输入 \\(x\\) 具有相同的方差,那么在初始化期间我们应该确保每个权重 \\(w\\) 的方差为 \\(1/n\\)。由于 \\(\text{Var}(aX) = a^2\text{Var}(X)\\) 代表随机变量 \\(X\\) 和标量 \\(a\\),这意味着我们应该从单位高斯中提取,然后按 \\(a = \sqrt{1/n}\\) 缩放,使其方差 \\(1/n\\)。这给出了初始化 w = np.random.randn(n) / sqrt(n)。
Glorot 等人在《理解深层前馈神经网络的训练困难》中进行了类似分析,建议采用 \\( \text{Var}(w) = 2/(n_{in} + n_{out}) \\) 的初始化方式,其中 \\(n_{in}, n_{out}\\) 分别表示前一层与后一层的单元数。这是兼顾前向传播和反向传播梯度分析后得到的折中方案。He 等人随后在《深入研究整流激活函数:在 ImageNet 分类上超越人类水平》中针对 ReLU 推导初始化方法,得到方差应为 \\(2.0/n\\),对应实现为 w = np.random.randn(n) * sqrt(2.0/n)。原文建议在使用 ReLU 的神经网络中采用这一初始化方式。
稀疏初始化。解决未校准方差问题的另一种方法是将所有权重矩阵设置为零,但为了打破对称性,每个神经元都随机连接(如上所述从小高斯采样权重)到其下方固定数量的神经元。要连接的神经元的典型数量可能只有 10 个。
初始化偏置。将偏置初始化为零是可能且常见的,因为不对称性破坏是由权重中的小随机数提供的。对于 ReLU 非线性,有些人喜欢对所有偏置使用较小的常数值,例如 0.01,因为这可以确保所有 ReLU 单元在开始时启动,从而获得并传播一些梯度。然而,尚不清楚这是否提供了一致的改进(事实上,一些结果似乎表明这表现更差),并且更常见的是简单地使用 0 偏置初始化。
在实践中,当前建议是使用 ReLU 单元并使用 w = np.random.randn(n) * sqrt(2.0/n),如 He 等人中所述。
批归一化。Ioffe 与 Szegedy 提出的批归一化(Batch Normalization)技术,通过在训练开始时显式地使网络各层激活值具有标准高斯分布,缓解了神经网络初始化方面的许多困难。关键在于,归一化本身是一个简单的可微运算。实现时,通常将 BatchNorm 层放在全连接层或卷积层之后、非线性激活之前。原论文已有详细说明,此处不再展开;需要注意的是,批归一化已经成为神经网络中的常用做法。在实践中,使用它的网络对不理想的初始化更为稳健。也可以把它理解为在网络每一层进行预处理,并以可微的方式将这种处理直接整合进网络。
正则化
有几种方法可以控制神经网络的容量以防止过拟合:
L2 正则化可能是最常见的正则化形式。它可以通过直接在目标中惩罚所有参数的平方大小来实现。也就是说,对于网络中的每个权重 \\(w\\),我们将项 \\(\frac{1}{2} \lambda w^2\\) 添加到目标中,其中 \\(\lambda\\) 是正则化强度。前面经常会看到 \\(\frac{1}{2}\\) 因子,因为那么这项相对于参数 \\(w\\) 的梯度就是 \\(\lambda w\\) 而不是 \\(2 \lambda w\\)。 L2 正则化对严重惩罚峰值权重向量和偏好扩散权重向量具有直观的解释。正如我们在线性分类部分中讨论的,由于权重和输入之间的乘法相互作用,这具有鼓励网络稍微使用其所有输入而不是大量使用其某些输入的吸引人的特性。最后,请注意,在梯度下降参数更新期间,使用 L2 正则化最终意味着每个权重都会线性衰减:W += -lambda * W 趋向于零。
L1 正则化是另一种相对常见的正则化形式,其中对于每个权重 \\(w\\),我们将项 \\(\lambda \mid w \mid\\) 添加到目标中。可以将 L1 正则化与 L2 正则化结合起来:\\(\lambda_1 \mid w \mid + \lambda_2 w^2\\)(这称为弹性网正则化)。 L1 正则化具有一个有趣的特性,即它会导致权重向量在优化过程中变得稀疏(即非常接近于零)。换句话说,具有 L1 正则化的神经元最终仅使用其最重要输入的稀疏子集,并且对于“噪声”输入几乎保持不变。相比之下,L2 正则化的最终权重向量通常是分散的、较小的数字。在实践中,如果您不关心显式特征选择,L2 正则化有望提供优于 L1 的性能。
最大范数限制。正则化的另一种形式是对每个神经元的权重向量的大小强制施加绝对上限,并使用投影梯度下降来强制约束。实际上,这对应于正常执行参数更新,然后通过限制每个神经元的权重向量 \\(\vec{w}\\) 以满足 \\(\Vert \vec{w} \Vert_2 < c\\) 来强制约束。 \\(c\\) 的典型值约为 3 或 4。有些人报告使用这种形式的正则化时有所改进。其吸引人的特性之一是,即使学习率设置得太高,网络也不会“爆炸”,因为更新总是有界的。
Dropout 是 Srivastava 等人最近推出的一种极其有效、简单的正则化技术。在Dropout:防止神经网络过拟合的简单方法 (pdf) 中,它补充了其他方法(L1、L2、maxnorm)。在训练时,dropout 是通过仅以某种概率 \\(p\\) (超参数)保持神经元活跃,或者将其设置为零来实现的。
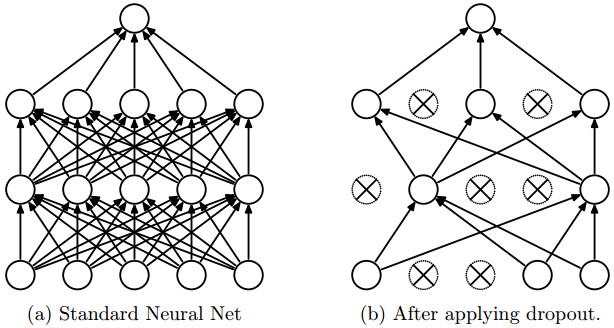
示例 3 层神经网络中的普通 dropout 将按如下方式实现:
""" Vanilla Dropout: Not recommended implementation (see notes below) """

p = 0.5 # probability of keeping a unit active. higher = less dropout

def train_step(X):
  """ X contains the data """

  # forward pass for example 3-layer neural network
  H1 = np.maximum(0, np.dot(W1, X) + b1)
  U1 = np.random.rand(*H1.shape) < p # first dropout mask
  H1 *= U1 # drop!
  H2 = np.maximum(0, np.dot(W2, H1) + b2)
  U2 = np.random.rand(*H2.shape) < p # second dropout mask
  H2 *= U2 # drop!
  out = np.dot(W3, H2) + b3

  # backward pass: compute gradients... (not shown)
  # perform parameter update... (not shown)

def predict(X):
  # ensembled forward pass
  H1 = np.maximum(0, np.dot(W1, X) + b1) * p # NOTE: scale the activations
  H2 = np.maximum(0, np.dot(W2, H1) + b2) * p # NOTE: scale the activations
  out = np.dot(W3, H2) + b3
在上面的代码中,在 train_step 函数内部,我们执行了两次 dropout:在第一个隐藏层和第二个隐藏层。也可以在输入层上执行 dropout,在这种情况下,我们还将为输入 X 创建一个二进制掩码。反向传播保持不变,但当然必须考虑生成的掩码 U1,U2。
至关重要的是,请注意,在 predict 函数中,我们不再丢弃,而是通过 \\(p\\) 对两个隐藏层输出进行缩放。这很重要,因为在测试时所有神经元都会看到它们的所有输入,因此我们希望神经元在测试时的输出与其在训练时的输出的期望值相同。例如,在 \\(p = 0.5\\) 的情况下,神经元必须在测试时将其输出减半,以获得与训练时相同的输出(预期)。要看到这一点,请考虑神经元 \\(x\\) 的输出(在应用 Dropout 之前)。通过 dropout,该神经元的输出的期望值将变为 \\(px + (1-p)0\\),因为神经元的输出将以概率 \\(1-p\\) 设置为零。在测试时,当我们保持神经元始终处于活动状态时,我们必须调整 \\(x \rightarrow px\\) 以保持相同的输出的期望值。还可以证明,在测试时执行这种衰减可以与迭代所有可能的二进制掩码(以及因此所有指数级多的子网络)并计算其整体预测的过程相关。
上述方案的问题是,测试时仍须将激活值乘以 \\(p\\)。由于推理效率十分重要,更适合使用反向缩放 Dropout(inverted dropout):把缩放放在训练阶段完成,测试阶段的前向传播保持不变。这样,无论调整 Dropout 的位置,还是取消 Dropout,都不需要改动预测代码。其实现如下:
"""
Inverted Dropout: Recommended implementation example.
We drop and scale at train time and don't do anything at test time.
"""

p = 0.5 # probability of keeping a unit active. higher = less dropout

def train_step(X):
  # forward pass for example 3-layer neural network
  H1 = np.maximum(0, np.dot(W1, X) + b1)
  U1 = (np.random.rand(*H1.shape) < p) / p # first dropout mask. Notice /p!
  H1 *= U1 # drop!
  H2 = np.maximum(0, np.dot(W2, H1) + b2)
  U2 = (np.random.rand(*H2.shape) < p) / p # second dropout mask. Notice /p!
  H2 *= U2 # drop!
  out = np.dot(W3, H2) + b3

  # backward pass: compute gradients... (not shown)
  # perform parameter update... (not shown)

def predict(X):
  # ensembled forward pass
  H1 = np.maximum(0, np.dot(W1, X) + b1) # no scaling necessary
  H2 = np.maximum(0, np.dot(W2, H1) + b2)
  out = np.dot(W3, H2) + b3
在首次引入 dropout 之后,进行了大量的研究,试图了解其在实践中的力量来源,以及它与其他正则化技术的关系。建议感兴趣的读者进一步阅读包括:
- Srivastava 等人的Dropout论文。 2014年。
- 丢弃训练作为自适应正则化:“我们表明,丢弃正则化器是一阶等效于通过估计逆对角费舍尔信息矩阵来缩放特征后应用的 L2 正则化器”。
在前向传播中引入随机性。Dropout 属于一类更一般的方法:训练时在网络前向传播中引入随机行为,测试时消除这种随机性带来的影响。可以用解析方式对随机性求平均,例如前述 Dropout 中乘以 \\(p\\);也可以用数值方式,例如在不同随机采样下执行多次前向传播,再对结果求平均。相关方法还有 DropConnect,它在前向传播时随机将部分权重置零。后面介绍的卷积网络也会使用类似思路,包括随机池化、分数池化和数据增强。
偏置正则化。正如我们在线性分类部分中已经提到的,对偏置参数进行正则化并不常见,因为它们不通过乘法交互与数据交互,因此没有控制数据维度对最终目标的影响的解释。然而,在实际应用中(并且通过适当的数据预处理),正则化偏置很少会导致性能显着下降。这可能是因为与所有权重相比,偏置项非常少,因此如果分类器需要偏置来获得更好的数据损失,则可以“负担得起”使用偏置。
每层正则化。将不同层调整为不同数量的情况并不常见(输出层可能除外)。文献中发表的关于这一想法的结果相对较少。
实践:最常见的是使用经过交叉验证的单一全局 L2 正则化强度。将其与在所有层之后应用的 dropout 结合起来也是很常见的。 \\(p = 0.5\\) 的值是合理的默认值,但这可以根据验证数据进行调整。
损失函数
我们已经讨论了目标的正则化损失部分,这可以被视为对模型复杂性的某些度量的惩罚。目标的第二部分是数据损失,它在监督学习问题中衡量预测(例如分类中的类别得分)和真实标签之间的兼容性。数据损失采用每个单独示例的数据损失的平均值的形式。也就是说,\\(L = \frac{1}{N} \sum_i L_i\\),其中\\(N\\) 是训练数据的数量。让我们将 \\(f = f(x_i; W)\\) 缩写为神经网络中输出层的激活。您可能希望在实践中解决以下几种类型的问题:
分类是我们迄今为止详细讨论的情况。在这里,我们假设一个示例数据集和每个示例的单个正确标签(固定集中)。此设置中两个最常见的代价函数之一是 SVM(例如 Weston Watkins 公式):
$$ L_i = \sum_{j\neq y_i} \max(0, f_j - f_{y_i} + 1) $$
正如我们简要提到的,有些人报告说平方合页损失具有更好的性能(即使用 \\(\max(0, f_j - f_{y_i} + 1)^2\\))。第二种常见的选择是使用交叉熵损失的 Softmax 分类器:
$$ L_i = -\log\left(\frac{e^{f_{y_i}}}{ \sum_j e^{f_j} }\right) $$
问题:类数量较多。当标签集非常大时(例如英语词典中的单词或包含 22,000 个类别的 ImageNet),计算完整的 softmax 概率会变得昂贵。对于某些应用程序,近似版本很受欢迎。例如,在自然语言处理任务中使用分层 Softmax 可能会有所帮助(请参阅此处 (pdf) 的解释)。分层 Softmax 将单词分解为树中的标签。然后,每个标签都表示为沿着树的路径,并且在树的每个节点上训练 Softmax 分类器,以消除左右分支之间的歧义。树的结构强烈影响性能并且通常取决于问题。
属性分类。上述两个损失都假设有一个正确答案 \\(y_i\\)。但是,如果 \\(y_i\\) 是一个二元向量,其中每个示例可能有也可能没有某个属性,并且这些属性不是唯一的,该怎么办?例如,Instagram 上的图像可以被认为是用大量所有主题标签中的某个主题标签子集进行标记的,并且一张图像可能包含多个主题标签。在这种情况下,一个明智的方法是为每个属性独立构建一个二元分类器。例如,每个类别独立的二元分类器将采用以下形式:
$$ L_i = \sum_j \max(0, 1 - y_{ij} f_j) $$
其中所有类别的总和为 \\(j\\),\\(y_{ij}\\) 为 +1 或 -1,具体取决于第 i 个示例是否用第 j 个属性标记,并且当预测该类存在时,得分向量 \\(f_j\\) 将为正,否则为负。请注意,如果正例的得分小于 +1,或者负例的得分大于 -1,则损失会累积。
这种损失的替代方法是为每个属性独立训练逻辑回归分类器。二元逻辑回归分类器只有两个类别 (0,1),并计算类别 1 的概率为:
$$ P(y = 1 \mid x; w, b) = \frac{1}{1 + e^{-(w^Tx +b)}} = \sigma (w^Tx + b) $$
由于类别 1 和类别 0 的概率之和为 1,因此类别 0 的概率为 \\(P(y = 0 \mid x; w, b) = 1 - P(y = 1 \mid x; w,b)\\)。因此,如果\\(\sigma (w^Tx + b) > 0.5\\),或者如果分数\\(w^Tx +b > 0\\),则示例被分类为正例(y = 1)。然后损失函数最大化这个概率。可以自行验证,这简化了最小化负对数似然:
$$ L_i = -\sum_j y_{ij} \log(\sigma(f_j)) + (1 - y_{ij}) \log(1 - \sigma(f_j)) $$
其中标签 \\(y_{ij}\\) 假定为 1(正)或 0(负),\\(\sigma(\cdot)\\) 是 sigmoid 函数。上面的表达式可能看起来很可怕,但 \\(f\\) 上的梯度实际上非常简单和直观: \\(\partial{L_i} / \partial{f_j} = \sigma(f_j) - y_{ij}\\) (因为您可以通过求导来仔细检查自己)。
回归是预测实际值的任务,例如房屋的价格或图像中某物的长度。对于此任务,通常计算预测量与真实答案之间的损失,然后测量差异的 L2 平方范数或 L1 范数。 L2 范数平方将计算以下形式的单个示例的损失:
$$ L_i = \Vert f - y_i \Vert_2^2 $$
L2 范数在目标中平方的原因是梯度变得更简单,而不改变最优参数,因为平方是单调操作。 L1 范数可以通过对每个维度的绝对值求和来表示:
$$ L_i = \Vert f - y_i \Vert_1 = \sum_j \mid f_j - (y_i)_j \mid $$
如果同时预测多个量,\\(\sum_j\\) 表示对全部预测维度求和。只看第 i 个样本的第 j 维,并以 \\(\delta_{ij}\\) 表示真实值与预测值之间的差异,该维度的梯度 \\(\partial{L_i} / \partial{f_j}\\) 很容易求出:L2 损失对应 \\(\delta_{ij}\\),L1 损失对应 \\(sign(\delta_{ij})\\)。因此,梯度要么与误差成正比,要么幅值固定、只保留误差的符号。
注意:L2 损失比 Softmax 等更稳定的损失更难优化。直观地说,它要求网络对每个输入及其增强样本都精确输出一个目标值,这种要求相当严格;Softmax 则不要求每个得分都取某个精确值,只要相对大小合适即可。此外,L2 损失对异常值不够稳健,异常值可能产生很大的梯度。面对回归任务,可以先考虑能否将输出划分为若干离散区间,转为分类。例如预测商品的 1—5 星评分时,为不同星级构建分类器可能比直接采用回归损失更有效。分类还可以给出不同输出的概率分布,而不只是一个缺少置信度信息的数值。如果确认分类不适合,再使用 L2 损失,并注意其敏感性;例如,在网络中使用 Dropout,特别是在紧邻 L2 损失的前一层使用,可能并不合适。
当面临回归任务时,首先考虑是否绝对必要。相反,强烈倾向于将输出离散化到容器中,并尽可能对它们进行分类。
结构化预测。结构化损失是指标签可以是任意结构的情况,例如图、树或其他复杂对象。通常还假设结构的空间非常大且不易枚举。结构化 SVM 损失背后的基本思想是要求正确结构 \\(y_i\\) 和得分最高的错误结构之间保持一定间隔。使用梯度下降来解决这个问题作为简单的无约束优化问题并不常见。相反,通常设计特殊的求解器,以便可以利用结构空间的特定简化假设。我们简要地提到了这个问题,但认为具体细节超出了课程的范围。
小结
总之:
- 建议的预处理是将数据居中,使其均值为零,并沿着每个特征将其尺度标准化为 [-1, 1]
- 通过从标准差为 \\(\sqrt{2/n}\\) 的高斯分布中绘制权重来初始化权重,其中 \\(n\\) 是神经元的输入数量。例如。在 numpy 中:
w = np.random.randn(n) * sqrt(2.0/n)。 - 使用 L2 正则化和 dropout(反转版本)
- 使用批归一化
- 我们讨论了您在实践中可能想要执行的不同任务,以及每个任务最常见的损失函数
我们现在已经预处理了数据并设置并初始化了模型。在下一节中,我们将研究学习过程及其动态。