神经网络(一):网络架构
本篇目录:
- 没有大脑类比的快速介绍
- 单个神经元的数学模型
- 生物学启发与对应关系
- 将单个神经元视为线性分类器
- 常用激活函数
- 神经网络架构
- 按层组织神经元
- 前向传播计算示例
- 表示能力
- 设置网络层数与各层神经元数量
- 小结
- 其他参考
简要介绍
引入神经网络而不需要大脑类比是可能的。在线性分类部分,我们使用公式 \\( s = W x \\) 计算给定图像的不同视觉类别的分数,其中 \\(W\\) 是矩阵,\\(x\\) 是包含图像所有像素数据的输入列向量。在 CIFAR-10 的情况下,\\(x\\) 是一个 [3072x1] 列向量,\\(W\\) 是一个 [10x3072] 矩阵,因此输出分数是 10 个类别得分的向量。
神经网络可以改为计算 \\( s = W_2 \max(0, W_1 x) \\)。例如,\\(W_1\\) 是 [100×3072] 矩阵,将图像映射为 100 维中间向量;\\(max(0,-) \\) 是逐元素的非线性函数,这里把小于 0 的激活值截为 0。还有其他非线性函数可选,后文会介绍。最后,形状为 [10×100] 的 \\(W_2\\) 再输出 10 个类别得分。非线性至关重要:去掉它后,两个矩阵的乘积可合并为一个矩阵,最终得分仍只是输入的线性函数。非线性正是网络获得更灵活表达能力的来源。参数 \\(W_2, W_1\\) 通过随机梯度下降学习,梯度由链式法则推导,并用反向传播计算。
三层神经网络可以类似地看起来像 \\( s = W_3 \max(0, W_2 \max(0, W_1 x)) \\),其中所有 \\(W_3, W_2, W_1\\) 都是要学习的参数。中间隐藏向量的大小是网络的超参数,稍后我们将看到如何设置它们。现在让我们看看如何从神经元/网络的角度解释这些计算。
单个神经元的数学模型
神经网络领域最初主要受到生物神经系统建模目标的启发,但后来发生了分歧,成为工程问题并在机器学习任务中取得良好的结果。尽管如此,我们还是以对生物系统的非常简短和高层次的描述开始我们的讨论,该领域的大部分内容都受到了该系统的启发。
生物学启发与对应关系
大脑的基本计算单元是神经元。人类神经系统中约有 860 亿个神经元,它们与大约 10^14 - 10^15 个突触 连接。下图显示了生物神经元的卡通图(左)和常见的数学模型(右)。每个神经元从其树突接收输入信号,并沿其(单个)轴突产生输出信号。轴突最终分支并通过突触连接到其他神经元的树突。在神经元的计算模型中,沿轴突传播的信号(例如 \\(x_0\\))根据该突触处的突触强度(例如 \\(w_0\\))与另一个神经元的树突进行乘法交互(例如 \\(w_0 x_0\\))。这个想法是,突触强度(权重 \\(w\\))是可学习的,并控制一个神经元对另一个神经元的影响强度(及其方向:兴奋性(正权重)或抑制性(负权重))。在基本模型中,树突将信号传送到细胞体,在那里信号全部被求和。如果最终总和高于某个阈值,神经元就会激发,沿着其轴突发送一个尖峰。在计算模型中,我们假设尖峰的精确时间并不重要,只有发射的频率才能传达信息。基于此频率编码解释,我们使用激活函数\\(f\\)对神经元的放电速率进行建模,它代表沿轴突的尖峰频率。从历史上看,激活函数的常见选择是 sigmoid 函数 \\(\sigma\\),因为它采用实值输入(求和后的信号强度)并将其压缩到 0 到 1 之间的范围。我们将在本节后面看到这些激活函数的详细信息。
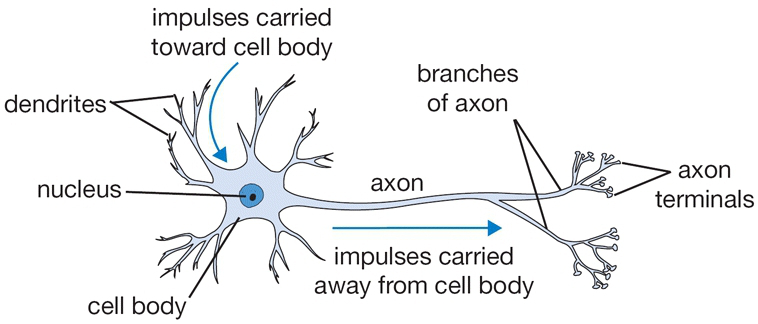
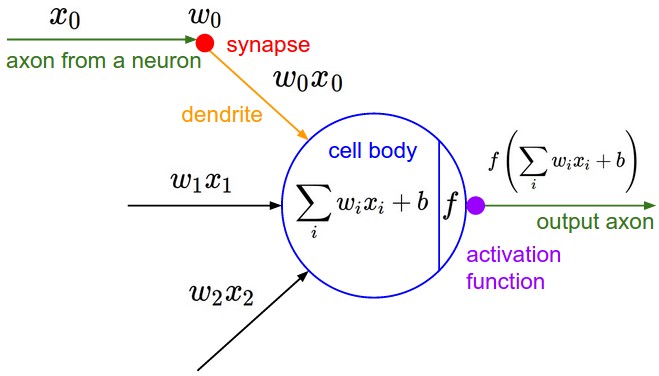
前向传播单个神经元的示例代码可能如下所示:
class Neuron(object):
  # ...
  def forward(self, inputs):
    """ assume inputs and weights are 1-D numpy arrays and bias is a number """
    cell_body_sum = np.sum(inputs * self.weights) + self.bias
    firing_rate = 1.0 / (1.0 + math.exp(-cell_body_sum)) # sigmoid activation function
    return firing_rate
换句话说,每个神经元与输入及其权重执行点积,添加偏置并应用非线性(或激活函数),在本例中为 sigmoid \\(\sigma(x) = 1/(1+e^{-x})\\)。我们将在本节末尾详细介绍不同的激活函数。
粗略模型。需要强调的是,这种生物神经元模型非常粗略:例如,有许多不同类型的神经元,每种类型都有不同的属性。生物神经元中的树突执行复杂的非线性计算。突触不仅仅是一个权重,它们是一个复杂的非线性动力系统。众所周知,许多系统中输出尖峰的确切时间非常重要,这表明频率编码近似可能不成立。由于所有这些和许多其他简化,如果您在神经网络和真实大脑之间进行类比,请准备好听到任何具有神经科学背景的人发出的呻吟声。如果您有兴趣,请参阅此评论 (pdf),或者最近的此评论。
将单个神经元视为线性分类器
Neuron 模型的前向计算的数学形式可能对您来说很熟悉。正如我们在线性分类器中看到的,神经元具有“喜欢”(接近 1 的激活)或“不喜欢”(接近 0 的激活)其输入空间的某些线性区域的能力。因此,通过神经元输出的适当损失函数,我们可以将单个神经元变成线性分类器:
二元 Softmax 分类器。例如,我们可以将 \\(\sigma(\sum_iw_ix_i + b)\\) 解释为类别之一 \\(P(y_i = 1 \mid x_i; w) \\) 的概率。另一类的概率为 \\(P(y_i = 0 \mid x_i; w) = 1 - P(y_i = 1 \mid x_i; w) \\),因为它们的总和必须为 1。通过这种解释,我们可以制定交叉熵损失,正如我们在线性分类部分中看到的那样,对其进行优化将产生二元 Softmax 分类器(也称为逻辑回归)。由于 sigmoid 函数被限制在 0-1 之间,因此该分类器的预测基于神经元的输出是否大于 0.5。
二分类 SVM 分类器。或者,我们可以将最大间隔合页损失附加到神经元的输出,并将其训练为二分类支持向量机。
正则化解释。在这种生物学观点中,SVM/Softmax 情况下的正则化损失可以解释为逐渐遗忘,因为它会在每次参数更新后将所有突触权重 \\(w\\) 推向零。
单个神经元可用于实现二元分类器(例如二元 Softmax 或二分类 SVM 分类器)
常用激活函数
每个激活函数(或非线性)都采用一个数字并对其执行某种固定的数学运算。在实践中你可能会遇到以下几种激活函数:
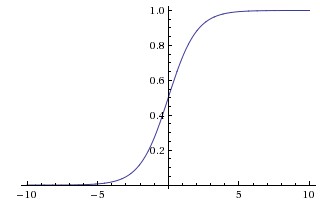
Sigmoid。 Sigmoid 非线性的数学形式为 \\(\sigma(x) = 1 / (1 + e^{-x})\\),如左上图所示。正如上一节提到的,它采用一个实数值并将其“压缩”到 0 到 1 之间的范围内。特别是,很大的负数趋近于 0,很大的正数趋近于 1。sigmoid 函数在历史上经常使用,因为它对神经元的放电率有一个很好的解释:从根本不放电 (0) 到以假定的最大频率完全饱和放电 (1)。在实践中,S 形非线性最近已失宠,并且很少使用。它有两个主要缺点:
- Sigmoid 饱和并阻断梯度传播。 sigmoid 神经元的一个非常不受欢迎的特性是,当神经元的激活在 0 或 1 的尾部饱和时,这些区域的梯度几乎为零。回想一下,在反向传播期间,这个(局部)梯度将乘以整个目标的该门输出的梯度。因此,如果局部梯度非常小,它将有效地阻断梯度传播,并且几乎没有信号会通过神经元流向其权重并递归地流向其数据。此外,在初始化 sigmoid 神经元的权重时必须格外小心,以防止饱和。例如,如果初始权重太大,那么大多数神经元将变得饱和,网络几乎无法学习。
- Sigmoid 输出不是以零为中心的。这是不可取的,因为神经网络中后续处理层中的神经元(稍后会详细介绍)将接收非以零为中心的数据。这对梯度下降过程中的动力学有影响,因为如果进入神经元的数据始终为正(例如 \\(f = w^Tx + b\\) 中的 \\(x > 0\\) 元素)),那么权重 \\(w\\) 上的梯度将在反向传播过程中要么全部为正,要么全部为负(取决于整个表达式 \\(f\\) 的梯度)。这可能会在权重的梯度更新中引入不理想的之字形更新轨迹。然而,请注意,一旦将这些梯度在一批数据中相加,权重的最终更新可能会出现不同的正负号,从而在一定程度上缓解了这个问题。因此,这虽然带来不便,但与上面的饱和激活问题相比,其后果不太严重。
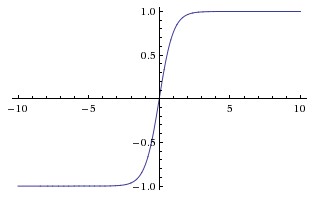
Tanh。上方右图给出了 tanh 非线性函数,它将实数压缩到 [-1, 1]。与 sigmoid 一样,tanh 的激活值也会饱和;但不同的是,它的输出以 0 为中心。因此在实践中,应优先选择 tanh,而不是 sigmoid。tanh 也可以看作缩放、平移后的 sigmoid,具体关系为 \\( \tanh(x) = 2 \sigma(2x) -1 \\)。
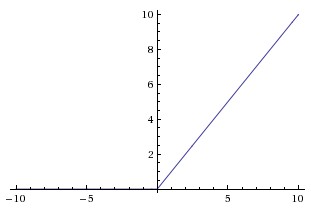
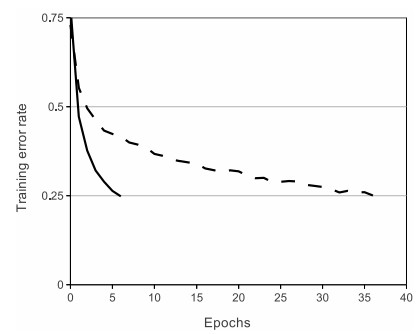
ReLU。 整流线性单元在过去几年中变得非常流行。它计算函数 \\(f(x) = \max(0, x)\\)。换句话说,激活的阈值简单地为零(参见左上图)。使用 ReLU 有几个优点和缺点:
- (+) 与 sigmoid/tanh 函数相比,它可以极大地加速(例如 Krizhevsky 等人 中的 6 倍)随机梯度下降的收敛速度。有人认为这是由于其线性、非饱和形式造成的。
- (+) 与涉及昂贵运算(指数等)的 tanh/sigmoid 神经元相比,ReLU 可以通过简单地将激活矩阵阈值设置为零来实现。
- (-) 不幸的是,ReLU 单元在训练过程中可能很脆弱并且可能“失活”。例如,流过 ReLU 神经元的大梯度可能会导致权重更新,从而神经元将永远不会再次在任何数据点上激活。如果发生这种情况,那么从该点开始流过该单元的梯度将永远为零。也就是说,ReLU 单元在训练过程中可能会永久失活,因为它们可能会从数据流形中消失。例如,如果学习率设置得太高,您可能会发现多达 40% 的网络可能“失活”(即神经元在整个训练数据集中从未激活)。通过正确设置学习率,这个问题就不太常见了。
Leaky ReLU。Leaky ReLU 尝试缓解“ReLU 神经元失活”问题。对于 x < 0 的区域,它不再恒输出 0,而是保留一个很小的正斜率,例如 0.01。其计算形式为 \\(f(x) = \mathbb{1}(x < 0) (\alpha x) + \mathbb{1}(x>=0) (x) \\),其中 \\(\alpha\\) 是一个很小的常数。一些研究报告了这种激活函数的效果,但结果并不总是一致。还可以把负半轴的斜率设为各神经元可学习的参数,即 PReLU;何恺明等人在 2015 年的《深入研究整流器》中提出了这一方法。不过,它能否在不同任务上稳定带来收益,仍不明确。
最大输出。已经提出了不具有函数形式 \\(f(w^Tx + b)\\) 的其他类型的单位,其中非线性应用于权重和数据之间的点积。一种相对流行的选择是 Maxout 神经元(由 Goodfellow 等人最近推出),它概括了 ReLU 及其带泄漏的版本。 Maxout 神经元计算函数 \\(\max(w_1^Tx+b_1, w_2^Tx + b_2)\\)。请注意,ReLU 和 Leaky ReLU 都是这种形式的特例(例如,对于 ReLU,我们有 \\(w_1, b_1 = 0\\))。因此,Maxout 神经元享有 ReLU 单元的所有优点(线性操作机制、无饱和),并且没有其缺点(ReLU 永久失活)。然而,与 ReLU 神经元不同的是,它使每个神经元的参数数量加倍,从而导致参数总数很高。
我们对最常见的神经元类型及其激活函数的讨论到此结束。最后一点是,在同一网络中混合和匹配不同类型的神经元的情况非常罕见,尽管这样做没有根本问题。
TLDR:“我应该使用什么神经元类型?”使用 ReLU 非线性,小心你的学习率,并可能监控网络中“失活”单元的比例。如果您担心这个问题,请尝试 Leaky ReLU 或 Maxout。切勿使用 sigmoid。尝试 tanh,但预计它的效果比 ReLU/Maxout 更差。
神经网络架构
按层组织神经元
神经网络作为图中的神经元。神经网络被建模为以无环图连接的神经元集合。换句话说,一些神经元的输出可以成为其他神经元的输入。不允许循环,因为这意味着网络前向传播中存在无限循环。神经网络模型通常被组织成不同的神经元层,而不是任意组织的神经元连接。对于常规神经网络,最常见的层类型是全连接层,其中两个相邻层之间的神经元完全成对连接,但同一层内的神经元之间没有连接。下面是两个使用全连接层堆栈的神经网络拓扑示例:
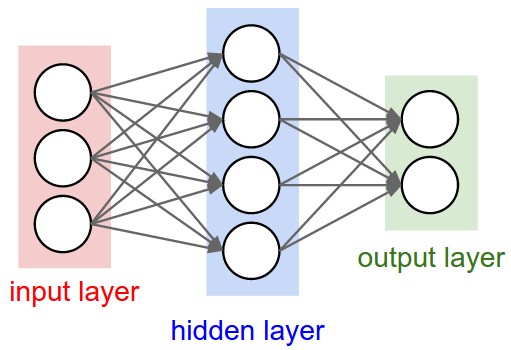
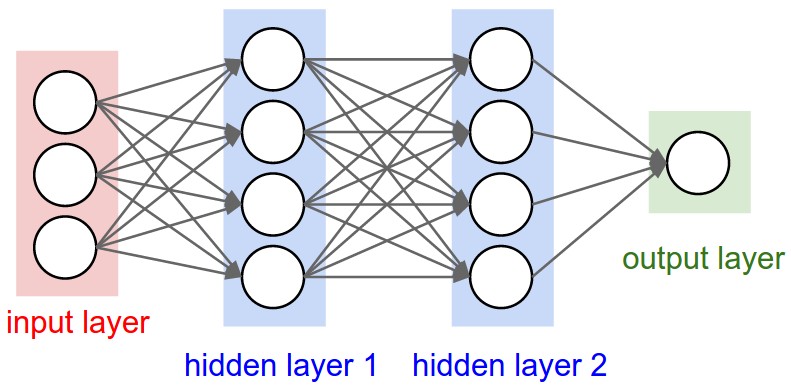
命名约定。所谓 N 层神经网络,通常不把输入层计入层数。因此,单层神经网络没有隐藏层,输入直接映射到输出。从这个意义上,也有人将逻辑回归或 SVM 看作单层神经网络的特例。这些网络也常被称为人工神经网络(ANN)或多层感知机(MLP)。一些研究者不喜欢将神经网络与真实大脑作类比,因此更倾向于将神经元称为单元(unit)。
输出层。与神经网络中的所有层不同,输出层神经元通常没有激活函数(或者您可以将它们视为具有线性恒等激活函数)。这是因为最后一个输出层通常用来表示类别得分(例如在分类中),它们是任意实数值,或某种实数值目标(例如在回归中)。
调整神经网络的大小。人们通常用来衡量神经网络大小的两个指标是神经元的数量,或更常见的是参数的数量。使用上图中的两个示例网络:
- 第一个网络(左)有 4 + 2 = 6 个神经元(不计算输入),[3 x 4] + [4 x 2] = 20 个权重和 4 + 2 = 6 个偏置,总共 26 个可学习参数。
- 第二个网络(右)有 4 + 4 + 1 = 9 个神经元,[3 x 4] + [4 x 4] + [4 x 1] = 12 + 16 + 4 = 32 个权重和 4 + 4 + 1 = 9 个偏置,总共 41 个可学习参数。
为了给您提供一些背景信息,现代卷积网络包含大约 1 亿个参数,通常由大约 10-20 层组成(因此深度学习)。然而,正如我们将看到的,由于参数共享,有效连接的数量显着增加。有关此内容的更多信息,请参阅卷积神经网络模块。
前向传播计算示例
重复矩阵乘法与激活函数交织。神经网络组织成层的主要原因之一是这种结构使得使用矩阵向量运算评估神经网络变得非常简单和高效。使用上图中的三层神经网络示例,输入将是一个 [3x1] 向量。层的所有连接强度都可以存储在单个矩阵中。例如,第一个隐藏层的权重 W1 的大小将为 [4x3],所有单元的偏置将位于大小为 [4x1] 的向量 b1 中。在这里,每个神经元的权重都在 W1 的一行中,因此矩阵向量乘法 np.dot(W1,x) 会评估该层中所有神经元的激活。类似地,W2 将是存储第二个隐藏层连接的 [4x4] 矩阵,而 W3 将是最后(输出)层的 [1x4] 矩阵。这个 3 层神经网络的完整前向传播就是三个矩阵乘法,与激活函数的应用交织在一起:
# forward-pass of a 3-layer neural network:
f = lambda x: 1.0/(1.0 + np.exp(-x)) # activation function (use sigmoid)
x = np.random.randn(3, 1) # random input vector of three numbers (3x1)
h1 = f(np.dot(W1, x) + b1) # calculate first hidden layer activations (4x1)
h2 = f(np.dot(W2, h1) + b2) # calculate second hidden layer activations (4x1)
out = np.dot(W3, h2) + b3 # output neuron (1x1)
在上面的代码中,W1,W2,W3,b1,b2,b3是网络的可学习参数。另请注意,变量 x 可以保存整批训练数据(其中每个输入示例将是 x 的列),而不是单个输入列向量,然后所有示例将被有效地并行评估。请注意,最终的神经网络层通常没有激活函数(例如,它表示分类设置中的(实值)类别得分)。
全连接层的前向传播对应于一个矩阵乘法,后跟一个偏置偏移和一个激活函数。
表示能力
看待具有全连接层的神经网络的一种方法是,它们定义了一系列由网络权重参数化的函数。一个自然出现的问题是:这个函数族的代表性能力是什么?特别是,是否存在无法用神经网络建模的功能?
事实证明,至少具有一个隐藏层的神经网络是通用逼近器。也就是说,它可以证明(例如,参见 1989 年的使用 sigmoid 函数叠加进行逼近(pdf),或 Michael Nielsen 的直观解释)给定任何连续函数 \\(f(x)\\) 和一些 \\(\epsilon > 0\\),有存在一个具有一个隐藏层的神经网络 \\(g(x)\\)(具有合理的非线性选择,例如 sigmoid),使得 \\( \forall x, \mid f(x) - g(x) \mid < \epsilon \\)。换句话说,神经网络可以逼近任何连续函数。
如果一个隐藏层足以近似任何函数,为什么要使用更多层并更深呢?答案是,两层神经网络是通用逼近器这一事实虽然在数学上很可爱,但在实践中却是一个相对较弱且无用的陈述。在一维中,“区间指示函数的加权和”函数 \\(g(x) = \sum_i c_i \mathbb{1}(a_i < x < b_i)\\)(其中 \\(a,b,c\\) 是参数向量)也是通用逼近器,但没有人建议我们在机器学习中使用这种函数形式。神经网络在实践中表现良好,因为它们紧凑地表达了良好、平滑的函数,非常适合我们在实践中遇到的数据的统计特性,并且使用我们的优化算法(例如梯度下降)也很容易学习。同样,更深的网络(具有多个隐藏层)比单隐藏层网络可以更好地工作,这一事实是一个经验观察结果,尽管它们的表示能力是相等的。
顺便说一句,在实践中,3 层神经网络的性能通常会优于 2 层网络,但更深(4、5、6 层)很少有更多帮助。这与卷积网络形成鲜明对比,在卷积网络中,深度被发现是良好识别系统的极其重要的组成部分(例如,大约 10 个可学习层)。这一观察的一个论点是图像包含分层结构(例如,面部由眼睛组成,眼睛由边缘组成等),因此多层处理对于该数据域具有直观意义。
当然,整个故事的内容要复杂得多,也是最近研究的主题。如果您对这些主题感兴趣,我们建议您进一步阅读:
- Bengio、Goodfellow、Courville 即将出版的深度学习书籍,特别是第 6.4 章。
- 深度网络真的需要很深吗?
- FitNets:薄深网的提示
设置网络层数与各层神经元数量
面对实际问题时,我们如何决定使用哪种架构?我们应该不使用隐藏层吗?一个隐藏层?两个隐藏层?每层应该有多大?首先,请注意,当我们增加神经网络的大小和层数时,网络的容量也会增加。也就是说,由于神经元可以协作表示许多不同的函数,因此可表示函数的空间不断扩大。例如,假设我们有一个二维的二元分类问题。我们可以训练三个独立的神经网络,每个神经网络都有一个一定大小的隐藏层,并获得以下分类器:
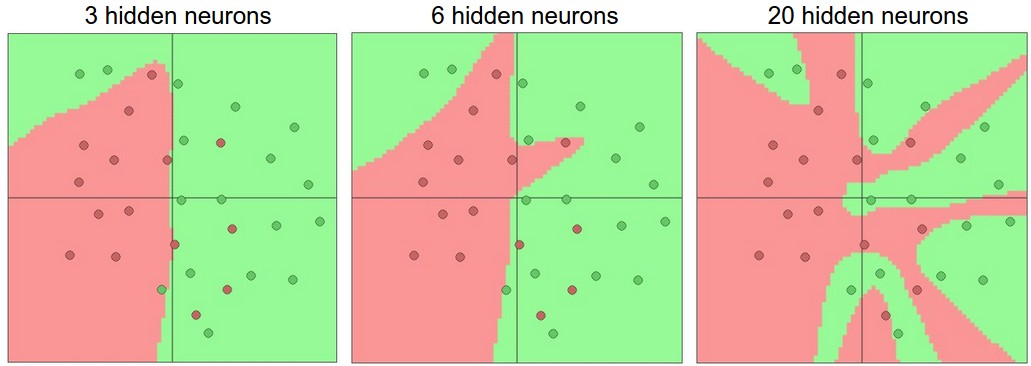
在上图中,我们可以看到具有更多神经元的神经网络可以表示更复杂的函数。然而,这既是一种祝福(因为我们可以学习对更复杂的数据进行分类),也是一种诅咒(因为更容易过拟合训练数据)。当高容量模型拟合数据中的噪声而不是(假设的)基础关系时,就会发生过拟合。例如,具有 20 个隐藏神经元的模型适合所有训练数据,但代价是将空间分割为许多不相交的红色和绿色决策区域。具有 3 个隐藏神经元的模型仅具有对数据进行粗略分类的表示能力。它将数据建模为两个斑点,并将绿色簇内的几个红点解释为异常值(噪声)。实际上,这可能会导致测试集更好的泛化。
根据我们上面的讨论,如果数据不够复杂以防止过拟合,似乎可以首选较小的神经网络。然而,这是不正确的——还有许多其他首选方法可以防止神经网络中的过拟合,我们将在稍后讨论(例如 L2 正则化、dropout、输入噪声)。在实践中,使用这些方法来控制过拟合总是比神经元数量更好。
这背后的微妙原因是,较小的网络更难使用梯度下降等局部方法进行训练:很明显,它们的损失函数具有相对较少的局部最小值,但事实证明,其中许多最小值更容易收敛,而且它们很糟糕(即损失很高)。相反,更大的神经网络包含更多的局部最小值,但这些最小值在实际损失方面要好得多。由于神经网络是非凸的,因此很难从数学上研究这些属性,但已经做出了一些尝试来理解这些目标函数,例如在最近的一篇论文多层网络的损失表面中。在实践中,你会发现,如果你训练一个小型网络,最终的损失可能会显示出很大的方差——在某些情况下,你很幸运并收敛到一个好的地方,但在某些情况下,你会陷入一个糟糕的最小值。另一方面,如果你训练一个大型网络,你将开始找到许多不同的解决方案,但最终实现的损失的方差会小得多。换句话说,所有解决方案都差不多一样好,并且较少依赖随机初始化的运气。
重申一下,正则化强度是控制神经网络过拟合的首选方法。我们可以看看三种不同设置所取得的结果:
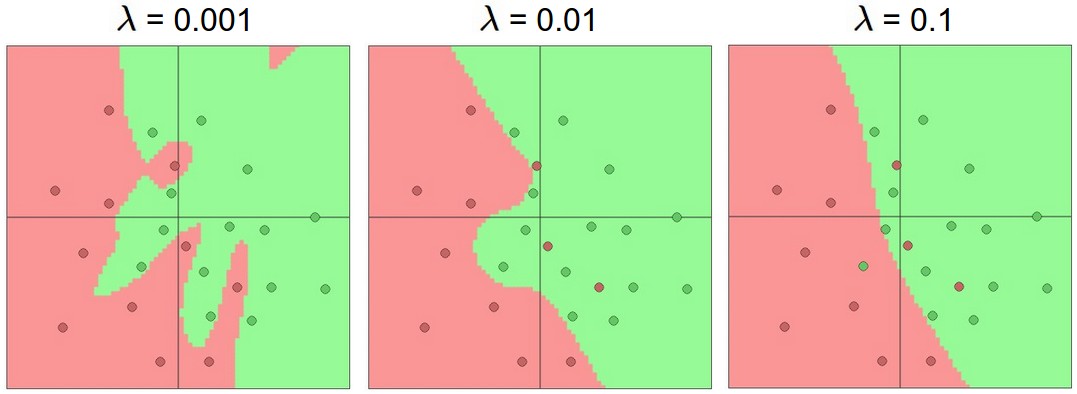
结论是您不应该使用较小的网络,因为您担心过拟合。相反,您应该在计算预算允许的范围内使用尽可能大的神经网络,并使用其他正则化技术来控制过拟合。
小结
总之,
- 我们引入了一个非常粗糙的生物神经元模型。
- 我们讨论了实践中使用的几种类型的激活函数,其中 ReLU 是最常见的选择。
- 我们引入了神经网络,其中神经元与全连接层连接,其中相邻层中的神经元具有完全成对连接,但层内的神经元不连接。
- 我们看到,这种分层架构能够非常有效地评估基于矩阵乘法与激活函数应用交织的神经网络。
- 我们看到神经网络是通用函数逼近器,但我们也讨论了这个属性与它们的普遍使用关系不大的事实。使用它们是因为它们对实践中出现的函数的函数形式做出了某些“正确”的假设。
- 我们讨论了这样一个事实:较大的网络总是比较小的网络工作得更好,但它们较高的模型容量必须通过更强的正则化(例如更高的权重衰减)来适当解决,否则它们可能会过拟合。我们将在后面的部分中看到更多形式的正则化(尤其是 dropout)。
补充参考资料
- 使用 Theano 的deeplearning.net 教程
- ConvNetJS 直觉演示
- Michael Nielsen 的教程