线性分类:支持向量机与 Softmax
本篇目录:
线性分类
在上一节中,我们介绍了图像分类问题,即从一组固定类别中为图像分配单个标签的任务。此外,我们描述了 k 最近邻 (kNN) 分类器,它通过将图像与训练集中的(带注释的)图像进行比较来标记图像。正如我们所见,kNN 有许多缺点:
- 分类器必须记住所有训练数据并将其存储以供将来与测试数据进行比较。这是空间效率低下的,因为数据集的大小很可能达到千兆字节。
- 对测试图像进行分类的代价很高,因为它需要与所有训练图像进行比较。
概述。我们现在将开发一种更强大的图像分类方法,最终将自然地扩展到整个神经网络和卷积神经网络。该方法将有两个主要组成部分:将原始数据映射到类别得分的得分函数,以及量化预测分数和真实标签之间的一致性的损失函数。然后,我们将其视为一个优化问题,其中我们将相对于得分函数的参数最小化损失函数。
从图像到类别得分的参数化映射
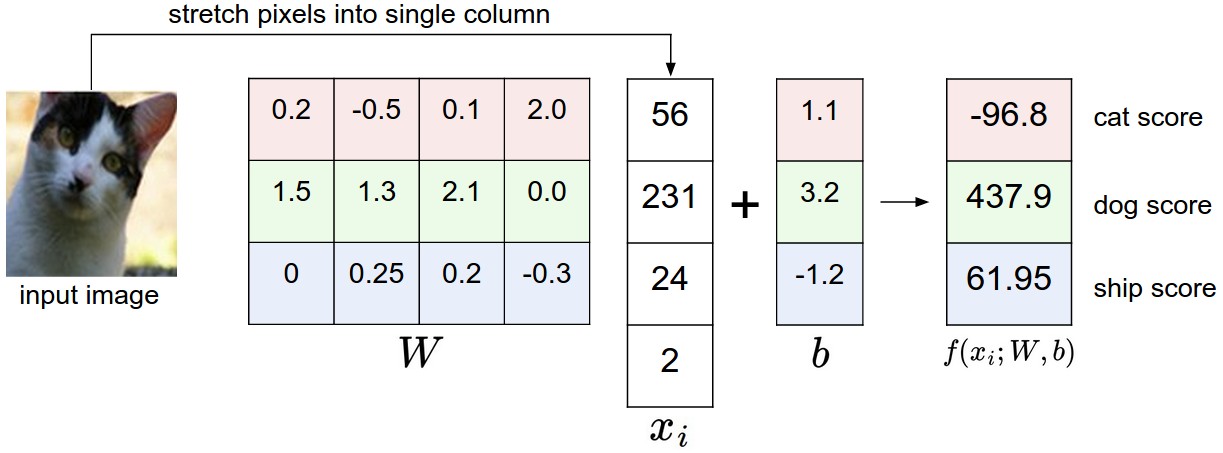
该方法的第一个组成部分是定义得分函数,将图像的像素值映射到每个类别的置信度得分。我们将通过一个具体的例子来开发该方法。和之前一样,我们假设一个图像训练数据集 \\( x_i \in R^D \\),每个图像都与一个标签 \\( y_i \\) 相关联。这里 \\( i = 1 \dots N \\) 和 \\( y_i \in \{ 1 \dots K \} \\)。也就是说,我们有 N 个示例(每个示例都有一个维度 D)和 K 个不同类别。例如,在 CIFAR-10 中,我们有一个训练集,其中包含 N = 50,000 张图像,每张图像的 D = 32 x 32 x 3 = 3072 像素,并且 K = 10,因为有 10 个不同的类别(狗、猫、汽车等)。我们现在将定义得分函数 \\(f: R^D \mapsto R^K\\),它将原始图像像素映射到类别得分。
线性分类器。在本模块中,我们将从可能最简单的函数开始,即线性映射:
$$ f(x_i, W, b) = W x_i + b $$
上式假定已将图像 \\(x_i\\) 的全部像素展平成形状为 [D×1] 的列向量。矩阵 W 的形状为 [K×D],向量 b 的形状为 [K×1],它们都是函数的参数。在 CIFAR-10 中,\\(x_i\\) 是第 i 张图像展平后的 [3072×1] 列向量,W 为 [10×3072],b 为 [10×1]:输入 3072 个原始像素数值,输出 10 个类别得分。W 中的参数通常称为权重,b 称为偏置向量,因为它直接影响输出得分,却不与输入数据 \\(x_i\\) 相乘。“权重”与“参数”这两个词在实际交流中也常被交替使用。
有几点需要注意:
- 首先,请注意,单矩阵乘法 \\(W x_i\\) 有效地并行评估 10 个单独的分类器(每个类一个),其中每个分类器是一行 W。
- 另请注意,我们认为输入数据 \\( (x_i, y_i) \\) 是给定且固定的,但我们可以控制参数 W,b 的设置。我们的目标是以计算出的分数与整个训练集中的真实标签相匹配的方式设置这些值。我们将更详细地了解如何完成此操作,但直观上我们希望正确的类别的分数高于不正确的类别的分数。
- 这种方法的一个优点是训练数据用于学习参数W,b,但是一旦学习完成,我们可以丢弃整个训练集,只保留学习到的参数。这是因为新的测试图像可以通过该函数简单地转发并根据计算的分数进行分类。
- 最后,请注意,对测试图像进行分类涉及单个矩阵乘法和加法,这比将测试图像与所有训练图像进行比较要快得多。
预示:卷积神经网络将图像像素精确地映射到分数,如上所示,但映射(f)将更复杂并且将包含更多参数。
理解线性分类器
请注意,线性分类器将类的分数计算为其所有 3 个颜色通道上的所有像素值的加权和。根据我们为这些权重设置的值,该函数能够喜欢或不喜欢(取决于每个权重的符号)图像中某些位置的某些颜色。例如,您可以想象,如果图像的侧面有很多蓝色(可能对应于水),则“船”类可能更有可能。您可能期望“船舶”分类器在其蓝色通道权重中具有大量正权重(蓝色的存在会增加船舶的得分),并且在红色/绿色通道中具有负权重(红色/绿色的存在会降低船舶的得分)。
将图像类比为高维点。由于图像被拉伸为高维列向量,因此我们可以将每个图像解释为该空间中的单个点(例如,CIFAR-10 中的每个图像都是 32x32x3 像素的 3072 维空间中的一个点)。类似地,整个数据集是一组(标记的)点。
由于我们将每个类别的分数定义为所有图像像素的加权和,因此每个类别的分数都是该空间上的线性函数。我们无法可视化 3072 维空间,但如果我们想象将所有这些维度压缩为仅二维,那么我们可以尝试可视化分类器可能在做什么:
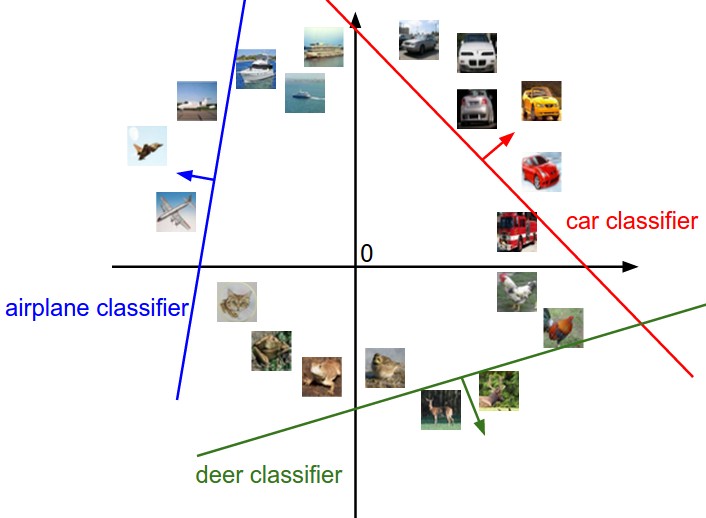
如前所述,\\(W\\) 的每一行对应一个类别的分类器。从几何上看,改变 \\(W\\) 中某一行的数值,会使像素空间中的相应直线改变方向;偏置 \\(b\\) 则使这条直线平移。若没有偏置项,无论权重如何,代入 \\( x_i = 0 \\) 都会得到 0 分,因此所有直线都被迫经过原点。
将线性分类器解释为模板匹配。 对权重 \\(W\\) 的另一种解释是,\\(W\\) 的每一行对应于其中一个类的一个模板(有时也称为原型)。然后,通过使用内积(或点积)将每个模板与图像一一比较,找到最“适合”的模板,从而获得图像的每个类别的分数。使用这个术语,线性分类器正在进行模板匹配,其中模板是被学习的。另一种思考方式是,我们仍然有效地进行最近邻,但我们不是拥有数千个训练图像,而是每个类仅使用单个图像(尽管我们将学习它,并且它不一定必须是训练集中的图像之一),并且我们使用(负)内积作为距离,而不是 L1 或 L2 距离。
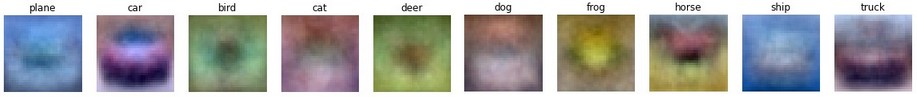
此外,请注意,马模板似乎包含双头马,这是由于数据集中同时有向左和向右的马。线性分类器将数据中的这两种马模式合并到一个模板中。同样,汽车分类器似乎将多种模式合并到一个模板中,该模板必须从各个方向识别所有颜色的汽车。特别是,该模板最终变成了红色,这表明 CIFAR-10 数据集中的红色汽车比任何其他颜色的汽车都多。线性分类器太弱,无法正确解释不同颜色的汽车,但正如我们稍后将看到的,神经网络将允许我们执行此任务。展望未来,神经网络将能够在其隐藏层中开发中间神经元,这些神经元可以检测特定的汽车类型(例如,绿色汽车朝左,蓝色汽车朝前等),而下一层的神经元可以通过各个汽车检测器的加权和将这些神经元组合成更准确的汽车分数。
偏置合并技巧。 在继续之前,我们想提一下一个常见的简化技巧,将两个参数 \\(W,b\\) 表示为一个。回想一下,我们将得分函数定义为:
$$ f(x_i, W, b) = W x_i + b $$
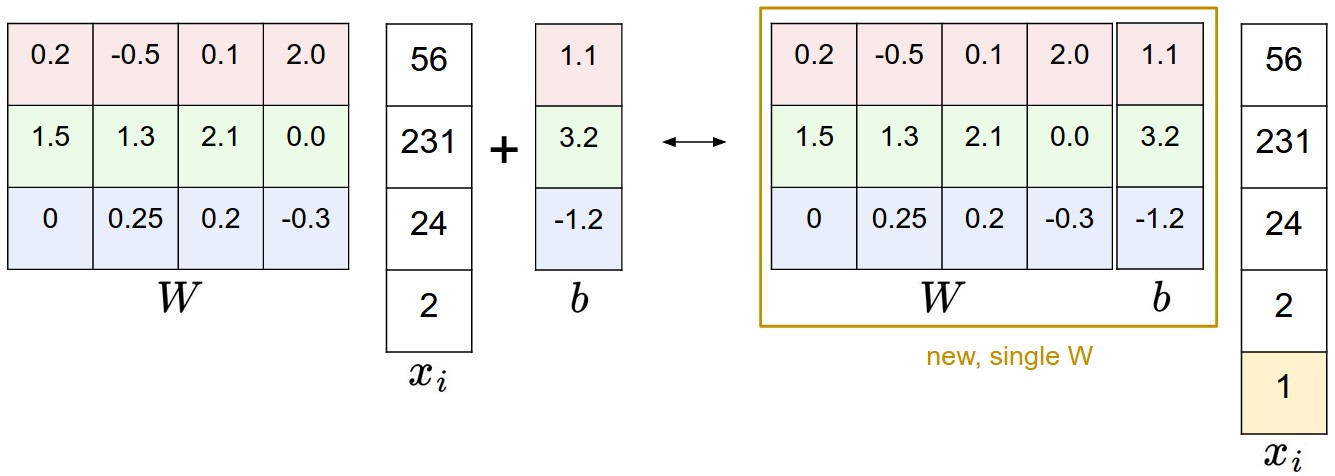
当我们继续学习材料时,分别跟踪两组参数(偏置 \\(b\\) 和权重 \\(W\\))有点麻烦。一种常用的技巧是通过将向量 \\(x_i\\) 扩展为一个始终保持常量 \\(1\\)(默认偏置维度)的附加维度,将两组参数组合成一个包含这两个参数的矩阵。有了额外的维度,新的得分函数将简化为单个矩阵乘法:
$$ f(x_i, W) = W x_i $$
在我们的 CIFAR-10 示例中,\\(x_i\\) 现在是 [3073 x 1],而不是 [3072 x 1] -(额外维度保持常数 1),而 \\(W\\) 现在是 [10 x 3073],而不是 [10 x 3072]。 \\(W\\) 的额外列现在对应于偏置 \\(b\\)。一个例子可能有助于澄清:
图像数据预处理。快速说明一下,在上面的示例中,我们使用了原始像素值(范围为 [0...255])。在机器学习中,始终对输入特征进行归一化是一种非常常见的做法(在图像的情况下,每个像素都被视为一个特征)。特别是,通过从每个特征中减去平均值来居中数据非常重要。对于图像,这相当于计算训练图像中的平均图像,并从每个图像中减去它,以获得像素范围约为 [-127 ... 127] 的图像。进一步常见的预处理是缩放每个输入特征,使其值范围在 [-1, 1] 之间。其中,零均值中心化可以说更重要,但我们必须等待它的合理性,直到我们了解梯度下降的动态。
损失函数
在上一节中,我们定义了一个从像素值到类别得分的函数,该函数由一组权重 \\(W\\) 参数化。此外,我们看到我们无法控制数据 \\( (x_i,y_i) \\) (它是固定和给定的),但我们确实可以控制这些权重,并且我们希望设置它们,以便预测的类别得分与训练数据中的真实标签一致。
例如,回到猫的示例图像及其“猫”、“狗”和“船”类的分数,我们发现该示例中的特定权重集根本不是很好:我们输入了描绘猫的像素,但与其他类(狗分数 437.9 和船分数 61.95)相比,猫分数非常低(-96.8)。我们将使用损失函数(有时也称为代价函数或目标)来衡量我们对这样的结果的不满意程度。直观上,如果我们对训练数据的分类做得不好,损失就会很高,如果我们做得很好,损失就会很低。
多类支持向量机损失
有多种方法可以定义损失函数的细节。作为第一个示例,我们将首先开发一种常用的损失,称为多类支持向量机 (SVM) 损失。 SVM 损失的设置是为了让 SVM“希望”每个图像的正确类别的分数比不正确的类别高一些固定的间隔 \\(\Delta\\)。请注意,像我们上面所做的那样,有时将损失函数拟人化是有帮助的:SVM“想要”某个结果,因为该结果会产生较低的损失(这很好)。
现在让我们变得更精确。回想一下,对于第 i 个示例,我们给出了图像 \\( x_i \\) 的像素和指定正确类索引的标签 \\( y_i \\)。得分函数采用像素并计算类别得分的向量 \\( f(x_i, W) \\),我们将其缩写为 \\(s\\)(分数的缩写)。 例如,第 j 个类别的分数是第 j 个元素:\\( s_j = f(x_i, W)_j \\)。第 i 个示例的多类 SVM 损失形式化如下:
$$ L_i = \sum_{j\neq y_i} \max(0, s_j - s_{y_i} + \Delta) $$
示例。让我们用一个示例来解压它,看看它是如何工作的。假设我们有三个类别,其得分为 \\( s = [13, -7, 11]\\),并且第一个类别是真实类别(即 \\(y_i = 0\\))。还假设 \\(\Delta\\) (我们将很快详细介绍的超参数)为 10。上面的表达式对所有不正确的类 (\\(j \neq y_i\\)) 求和,因此我们得到两项:
$$ L_i = \max(0, -7 - 13 + 10) + \max(0, 11 - 13 + 10) $$
您可以看到第一项给出零,因为 [-7 - 13 + 10] 给出负数,然后使用 \\(max(0,-)\\) 函数将其阈值为零。我们对这一对的损失为零,因为正确的类别得分 (13) 比错误的类别得分 (-7) 至少大 10。事实上,差值是 20,远大于 10,但 SVM 只关心差值至少为 10;通过最大操作,任何高于间隔的额外差异都会被限制为零。第二项计算 [11 - 13 + 10],得出 8。也就是说,即使正确的类别比不正确的类别得分更高 (13 > 11),但它并没有超出所需的 10 分。差异仅为 2,这就是损失为 8 的原因(即,差异必须高出多少才能满足间隔)。总之,SVM 损失函数希望正确类别的分数 \\(y_i\\) 比错误类别的分数至少大 \\(\Delta\\) (增量)。如果不是这样,我们就会积累损失。
请注意,在这个特定的模块中,我们使用的是线性得分函数( \\( f(x_i; W) = W x_i \\) ),因此我们也可以以这种等效形式重写损失函数:
$$ L_i = \sum_{j\neq y_i} \max(0, w_j^T x_i - w_{y_i}^T x_i + \Delta) $$
其中 \\(w_j\\) 是 \\(W\\) 重塑为列的第 j 行。然而,一旦我们开始考虑更复杂形式的得分函数 \\(f\\),情况就不一定是这样了。
最后补充一个术语:将结果在 0 处截断的 \\(max(0,-)\\) 形式通常称为合页损失(hinge loss)。有时也会使用平方合页损失 SVM(或称 L2-SVM),其形式为 \\(max(0,-)^2\\),以二次而非线性的方式更强地惩罚未满足间隔要求的情况。不平方的形式更常见,但平方形式在某些数据集上可能效果更好,可以通过交叉验证作出选择。
损失函数通过对训练集的预测来量化我们的不满
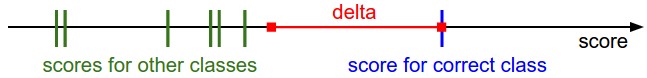
正则化。我们上面介绍的损失函数有一个错误。假设我们有一个数据集和一组参数 W ,它们可以正确地对每个示例进行分类(即所有分数都满足所有间隔,并且所有 i 的 \\(L_i = 0\\) )。问题在于,这组 W 不一定是唯一的:可能有许多类似的 W 可以正确对示例进行分类。看到这一点的一种简单方法是,如果某些参数 W 正确地对所有示例进行分类(因此每个示例的损失为零),则这些参数 \\( \lambda W \\) 的任何倍数(其中 \\( \lambda > 1 \\) )也将给出零损失,因为此转换均匀地拉伸所有分数大小,因此也拉伸它们的绝对差异。例如,如果正确类别和最接近的错误类别之间的分数差异为 15,则将 W 的所有元素乘以 2 将使新的差异为 30。
换句话说,我们希望对某些权重集W 的某些偏好进行编码,以消除这种歧义。我们可以通过使用 正则化惩罚 \\(R(W)\\) 扩展损失函数来实现这一点。最常见的正则化惩罚是平方 L2 范数,它通过对所有参数进行元素二次惩罚来阻止大权重:
$$ R(W) = \sum_k\sum_l W_{k,l}^2 $$
在上面的表达式中,我们对 \\(W\\) 的所有平方元素求和。请注意,正则化函数不是数据的函数,它仅基于权重。包括正则化惩罚完成了完整的多类支持向量机损失,它由两个部分组成:数据损失(即所有示例的平均损失 \\(L_i\\))和正则化损失。也就是说,完整的多类 SVM 损失变为:
$$ L = \underbrace{ \frac{1}{N} \sum_i L_i }_\text{data loss} + \underbrace{ \lambda R(W) }_\text{regularization loss} \\\\ $$
或者将其扩展为完整形式:
$$ L = \frac{1}{N} \sum_i \sum_{j\neq y_i} \left[ \max(0, f(x_i; W)_j - f(x_i; W)_{y_i} + \Delta) \right] + \lambda \sum_k\sum_l W_{k,l}^2 $$
其中\\(N\\)是训练样本的数量。正如您所看到的,我们将正则化惩罚附加到损失目标中,并由超参数 \\(\lambda\\) 进行加权。没有简单的方法来设置这个超参数,它通常是通过交叉验证来确定的。
除了我们上面提供的动机之外,还有许多理想的属性包括正则化惩罚,其中许多我们将在后面的部分中讨论。例如,事实证明,包含 L2 惩罚会导致 SVM 中具有吸引力的 最大间隔 属性(如果您感兴趣,请参阅 CS229 讲义了解完整详细信息)。
最吸引人的特性是,惩罚大的权重往往会提高泛化能力,因为这意味着任何输入维度本身都不会对分数产生很大的影响。例如,假设我们有一些输入向量 \\(x = [1,1,1,1] \\) 和两个权重向量 \\(w_1 = [1,0,0,0]\\)、\\(w_2 = [0.25,0.25,0.25,0.25] \\)。那么 \\(w_1^Tx = w_2^Tx = 1\\) 因此两个权重向量会产生相同的点积,但是 \\(w_1\\) 的 L2 惩罚是 1.0,而 \\(w_2\\) 的 L2 惩罚只有 0.25。因此,根据 L2 惩罚,权重向量 \\(w_2\\) 将是首选,因为它实现了较低的正则化损失。直观上,这是因为 \\(w_2\\) 中的权重更小且更分散。由于 L2 惩罚更喜欢更小、更分散的权重向量,因此鼓励最终分类器少量考虑所有输入维度,而不是非常强烈地考虑少数输入维度。正如我们稍后将在课程中看到的,这种效果可以提高分类器在测试图像上的泛化性能,并减少过拟合。
请注意,偏置不会产生相同的效果,因为与权重不同,偏置不控制输入维度的影响强度。因此,通常只对权重 \\(W\\) 进行正则化,而不对偏置 \\(b\\) 进行正则化。然而,在实践中,这往往产生的影响可以忽略不计。最后,请注意,由于正则化惩罚,我们永远无法在所有示例中实现恰好为 0.0 的损失,因为这只有在 \\(W = 0\\) 的病态设置中才有可能。
代码。以下是在 Python 中实现的损失函数(没有正则化),包括非向量化和半向量化形式:
def L_i(x, y, W):
  """
  unvectorized version. Compute the multiclass svm loss for a single example (x,y)
  - x is a column vector representing an image (e.g. 3073 x 1 in CIFAR-10)
    with an appended bias dimension in the 3073-rd position (i.e. bias trick)
  - y is an integer giving index of correct class (e.g. between 0 and 9 in CIFAR-10)
  - W is the weight matrix (e.g. 10 x 3073 in CIFAR-10)
  """
  delta = 1.0 # see notes about delta later in this section
  scores = W.dot(x) # scores becomes of size 10 x 1, the scores for each class
  correct_class_score = scores[y]
  D = W.shape[0] # number of classes, e.g. 10
  loss_i = 0.0
  for j in range(D): # iterate over all wrong classes
    if j == y:
      # skip for the true class to only loop over incorrect classes
      continue
    # accumulate loss for the i-th example
    loss_i += max(0, scores[j] - correct_class_score + delta)
  return loss_i

def L_i_vectorized(x, y, W):
  """
  A faster half-vectorized implementation. half-vectorized
  refers to the fact that for a single example the implementation contains
  no for loops, but there is still one loop over the examples (outside this function)
  """
  delta = 1.0
  scores = W.dot(x)
  # compute the margins for all classes in one vector operation
  margins = np.maximum(0, scores - scores[y] + delta)
  # on y-th position scores[y] - scores[y] canceled and gave delta. We want
  # to ignore the y-th position and only consider margin on max wrong class
  margins[y] = 0
  loss_i = np.sum(margins)
  return loss_i

def L(X, y, W):
  """
  fully-vectorized implementation :
  - X holds all the training examples as columns (e.g. 3073 x 50,000 in CIFAR-10)
  - y is array of integers specifying correct class (e.g. 50,000-D array)
  - W are weights (e.g. 10 x 3073)
  """
  # evaluate loss over all examples in X without using any for loops
  # left as exercise to reader in the assignment
本节的要点是,SVM 损失采用一种特殊的方法来衡量训练数据的预测与真实标签的一致性。此外,对训练集做出良好的预测相当于最小化损失。
我们现在要做的就是想出一种方法来找到最小化损失的权重。
实际应用中的注意事项
设置 Delta。 请注意,我们忽略了超参数 \\(\Delta\\) 及其设置。它应该设置为什么值,我们是否必须交叉验证它?事实证明,在所有情况下,这个超参数都可以安全地设置为 \\(\Delta = 1.0\\)。超参数 \\(\Delta\\) 和 \\(\lambda\\) 看起来像是两个不同的超参数,但实际上它们都控制相同的权衡:目标中数据损失和正则化损失之间的权衡。理解这一点的关键是权重 \\(W\\) 的大小对分数有直接影响(因此也影响它们的差异):当我们缩小 \\(W\\) 内的所有值时,分数差异将变得更低,而当我们扩大权重时,分数差异将全部变得更高。因此,分数之间的差距的确切值(例如 \\(\Delta = 1\\) 或 \\(\Delta = 100\\))在某种意义上是没有意义的,因为权重可以任意缩小或拉伸差异。因此,唯一真正的权衡是我们允许权重增长多大(通过正则化强度 \\(\lambda\\))。
与二分类支持向量机的关系。您可能已经具备二分类支持向量机方面的经验来参加本课程,其中第 i 个示例的损失可以写为:
$$ L_i = C \max(0, 1 - y_i w^Tx_i) + R(W) $$
其中 \\(C\\) 是超参数,\\(y_i \in \\{ -1,1 \\} \\)。可以自行验证,我们在本节中提出的公式包含二分类 SVM 作为只有两个类时的特殊情况。也就是说,如果我们只有两个类,那么损失就会减少到上面所示的二分类 SVM。此外,该公式中的 \\(C\\) 和我们公式中的 \\(\lambda\\) 控制相同的权衡,并通过反比关系 \\(C \propto \frac{1}{\lambda}\\) 相关。
补充:在原始问题上进行优化。了解过 SVM 的同学可能听说过核方法、对偶问题、SMO 算法等。本课程与一般的神经网络训练一样,直接处理无约束形式的原始优化目标。许多目标并非处处可微,例如 max(x,y) 在 x=y 处存在不可导拐点;实践中通常使用次梯度来处理,因此这并不妨碍优化。
补充:多类别 SVM 的其他形式。本节给出的只是将 SVM 扩展到多类别任务的几种方式之一。另一种常见方法是一对其余(One-Vs-All,OVA):为每个类别分别训练一个二分类 SVM,用来区分该类与其他所有类别。相关但较少使用的方法是两两分类(All-vs-All,AVA)。本节采用 Weston 与 Watkins 于 1999 年提出的形式(PDF)。从某种意义上说,它比 OVA 更强:可以构造一个多类别数据集,使本节形式达到零数据损失,而 OVA 做不到;细节见原论文。你还可能遇到结构化 SVM,它最大化正确类别得分与最高错误类别得分之间的间隔。不同形式之间的详细比较超出了本课程范围。本节版本可以放心用于实践,但更简单的 OVA 往往也能达到相近效果,Rifkin 等人在 2004 年的《为一对其余分类方法辩护》(PDF)中也提出了这一观点。
Softmax 分类器
事实证明,SVM 是两种常见的分类器之一。另一种流行的选择是 Softmax 分类器,它具有不同的损失函数。如果您之前听说过二元 Logistic 回归分类器,那么 Softmax 分类器就是它对多个类的推广。与 SVM 将输出 \\(f(x_i,W)\\) 视为每个类别的(未校准且可能难以解释)分数不同,Softmax 分类器给出了稍微更直观的输出(归一化类别概率),并且还具有我们将很快描述的概率解释。在 Softmax 分类器中,函数映射 \\(f(x_i; W) = W x_i\\) 保持不变,但我们现在将这些分数解释为每个类别的未归一化对数概率,并将合页损失替换为交叉熵损失,其形式如下:
$$ L_i = -\log\left(\frac{e^{f_{y_i}}}{ \sum_j e^{f_j} }\right) \hspace{0.5in} \text{or equivalently} \hspace{0.5in} L_i = -f_{y_i} + \log\sum_j e^{f_j} $$
其中我们使用符号 \\(f_j\\) 来表示类别得分向量 \\(f\\) 的第 j 个元素。和以前一样,数据集的全部损失是所有训练示例的平均值 \\(L_i\\) 以及正则化项 \\(R(W)\\)。函数 \\(f_j(z) = \frac{e^{z_j}}{\sum_k e^{z_k}} \\) 称为 softmax 函数:它采用任意实数值分数的向量(在 \\(z\\) 中)并将其压缩为 0 到 1 之间且总和为 1 的值向量。如果您第一次看到涉及 softmax 函数的完整交叉熵损失,它可能看起来很可怕,但它相对容易激发。
信息论观点。 “真实”分布 \\(p\\) 和估计分布 \\(q\\) 之间的交叉熵定义为:
$$ H(p,q) = - \sum_x p(x) \log q(x) $$
因此,Softmax 分类器最小化估计类概率(如上所示的 \\(q = e^{f_{y_i}} / \sum_j e^{f_j} \\))和“真实”分布之间的交叉熵,在这种解释中,“真实”分布是所有概率质量都在正确类上的分布(即 \\(p = [0, \ldots 1, \ldots, 0]\\) 在第 \\(y_i\\) 位置包含单个 1)。此外,由于交叉熵可以用熵和 Kullback-Leibler 散度来写为 \\(H(p,q) = H(p) + D_{KL}(p\|\|q)\\),并且 delta 函数 \\(p\\) 的熵为零,这也相当于最小化两个分布之间的 KL 散度(距离的度量)。换句话说,交叉熵目标希望预测分布的所有质量都位于正确答案上。
概率解释。观察这个表达式,我们发现
$$ P(y_i \mid x_i; W) = \frac{e^{f_{y_i}}}{\sum_j e^{f_j} } $$
可以解释为给定图像 \\(x_i\\) 并由 \\(W\\) 参数化的情况下分配给正确标签 \\(y_i\\) 的(归一化)概率。要看到这一点,请记住 Softmax 分类器将输出向量 \\(f\\) 内的分数解释为未归一化对数概率。因此,对这些量取幂给出(未归一化的)概率,并且除法执行归一化,以便概率之和为 1。因此,在概率解释中,我们最小化正确类别的负对数似然,这可以解释为执行最大似然估计 (MLE)。这种观点的一个很好的特点是,我们现在还可以将完整损失函数中的正则化项 \\(R(W)\\) 解释为来自权重矩阵 \\(W\\) 的高斯先验,其中我们执行的是最大后验 (MAP) 估计,而不是 MLE。我们提到这些解释是为了帮助你的直觉,但是这个推导的完整细节超出了本课程的范围。
实际问题:数值稳定性。当您在实践中编写用于计算 Softmax 函数的代码时,由于指数的原因,中间项 \\(e^{f_{y_i}}\\) 和 \\(\sum_j e^{f_j}\\) 可能非常大。除以大数可能会在数值上不稳定,因此使用归一化技巧很重要。请注意,如果我们将分数的顶部和底部乘以常数 \\(C\\) 并将其推入总和,我们将得到以下(数学上等效的)表达式:
$$ \frac{e^{f_{y_i}}}{\sum_j e^{f_j}} = \frac{Ce^{f_{y_i}}}{C\sum_j e^{f_j}} = \frac{e^{f_{y_i} + \log C}}{\sum_j e^{f_j + \log C}} $$
我们可以自由选择\\(C\\) 的值。这不会改变任何结果,但我们可以使用该值来提高计算的数值稳定性。 \\(C\\) 的常见选择是设置 \\(\log C = -\max_j f_j \\)。这只是表明我们应该移动向量 \\(f\\) 内的值,以便最高值为零。在代码中:
f = np.array([123, 456, 789]) # example with 3 classes and each having large scores
p = np.exp(f) / np.sum(np.exp(f)) # Bad: Numeric problem, potential blowup

# instead: first shift the values of f so that the highest number is 0:
f -= np.max(f) # f becomes [-666, -333, 0]
p = np.exp(f) / np.sum(np.exp(f)) # safe to do, gives the correct answer
可能令人困惑的命名约定。准确地说,SVM 分类器使用合页损失,有时也称为最大间隔损失。 Softmax 分类器使用交叉熵损失。 Softmax 分类器的名称来自于 softmax 函数,该函数用于将原始类别得分压缩为总和为 1 的归一化正值,以便可以应用交叉熵损失。特别要注意的是,从技术上讲,谈论“softmax损失”是没有意义的,因为softmax只是挤压函数,但它是一个相对常用的简写。
SVM 与 Softmax 的比较
一张图片可能有助于阐明 Softmax 和 SVM 分类器之间的区别:
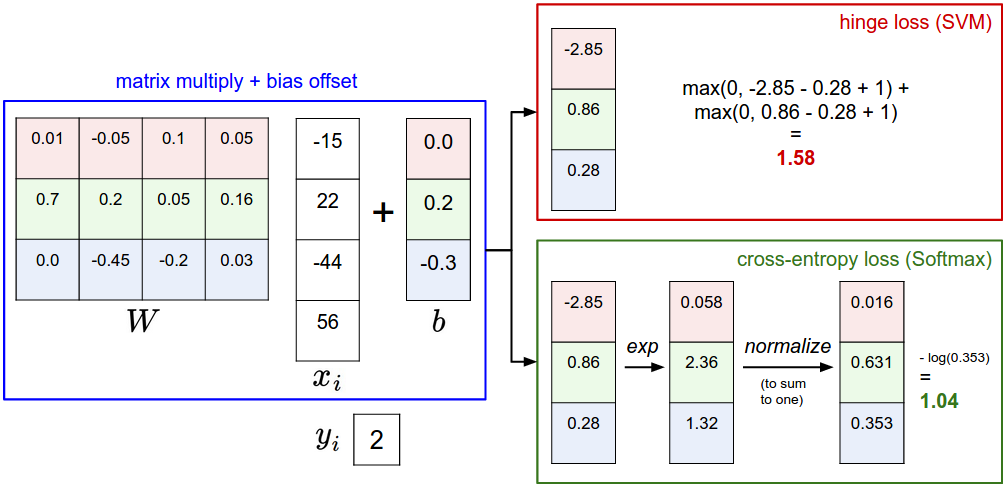
Softmax 分类器为每个类别提供“概率”。 与计算所有类别的未经校准且不易解释的分数的 SVM 不同,Softmax 分类器允许我们计算所有标签的“概率”。例如,给定图像,SVM 分类器可能会为“猫”、“狗”和“船”类提供 [12.5, 0.6, -23.0] 的分数。 softmax 分类器可以将三个标签的概率计算为 [0.9, 0.09, 0.01],这使您可以解释其在每个类别中的置信度。然而,我们将“概率”一词放在引号中的原因是,这些概率的峰值或扩散程度直接取决于正则化强度 \\(\lambda\\) - 您负责将其作为系统的输入。例如,假设某些三个类别的未归一化对数概率为 [1, -2, 0]。然后,softmax 函数将计算:
$$ [1, -2, 0] \rightarrow [e^1, e^{-2}, e^0] = [2.71, 0.14, 1] \rightarrow [0.7, 0.04, 0.26] $$
所采取的步骤是求幂并归一化以求和为一。现在,如果正则化强度 \\(\lambda\\) 较高,则权重 \\(W\\) 将受到更多惩罚,这将导致权重较小。例如,假设权重减小了一半 ([0.5, -1, 0])。 softmax 现在将计算:
$$ [0.5, -1, 0] \rightarrow [e^{0.5}, e^{-1}, e^0] = [1.65, 0.37, 1] \rightarrow [0.55, 0.12, 0.33] $$
现在概率更加分散。此外,在由于非常强的正则化强度 \\(\lambda\\) 导致权重趋于微小数字的限制下,输出概率将接近均匀。因此,Softmax 分类器计算的概率最好被视为置信度,与 SVM 类似,分数的排序是可解释的,但绝对数字(或其差异)在技术上是不可解释的。
在实际应用中,SVM 与 Softmax 的表现通常相近。两者的性能差异往往不大,对于哪一种更好,不同使用者可能有不同经验。与 Softmax 相比,SVM 的目标更具有局部性;这既可能被视为不足,也可能被视为优点。设某个样本的得分为 [10, -2, 3],且第一个类别正确。若 SVM 要求的间隔为 \\(\Delta = 1\\),正确类别与其他类别的得分差已经超过该间隔,因此损失为 0。SVM 不再关心得分的具体大小:即使改成 [10, -100, -100] 或 [10, 9, 9],只要间隔 1 得到满足,损失仍为 0。Softmax 则不同:[10, 9, 9] 的损失会明显高于 [10, -100, -100]。也就是说,Softmax 总可以通过继续提高正确类别的概率、降低错误类别的概率来进一步减小损失;SVM 在间隔满足后就不再对具体得分施加额外要求。这有时是有利的:例如,汽车分类器应把主要精力放在区分汽车与卡车等困难样本上,而不必继续受青蛙图像影响——后者的汽车类别得分已经很低,而且在数据空间中可能位于完全不同的区域。
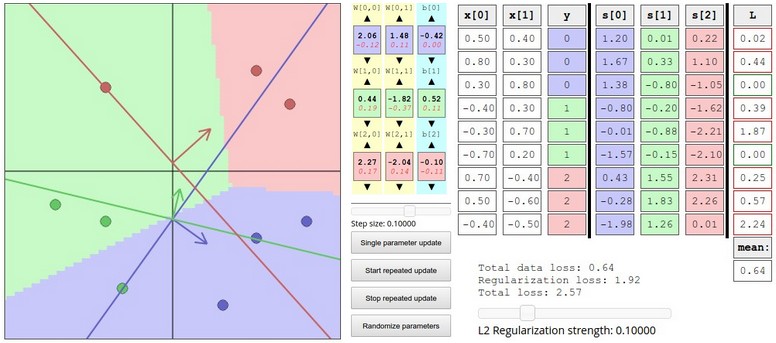
交互式网页演示
小结
总之,
- 我们定义了一个从图像像素到类别得分的得分函数(在本节中,是一个依赖于权重W和偏置b的线性函数)。
- 与 kNN 分类器不同,这种参数方法的优点是,一旦我们学习了参数,我们就可以丢弃训练数据。此外,对新测试图像的预测速度很快,因为它需要与 W 进行单个矩阵乘法,而不是与每个训练示例进行详尽的比较。
- 我们引入了偏置合并技巧,它允许我们将偏置向量折叠到权重矩阵中,以便只需要跟踪一个参数矩阵。
- 我们定义了一个损失函数(我们引入了线性分类器的两种常用损失:SVM和Softmax),用于衡量给定参数集与训练数据集中的真实标签的兼容性。我们还看到损失函数的定义方式是,对训练数据做出好的预测相当于损失很小。
我们现在看到了一种获取图像数据集并根据一组参数将每个图像映射到类别得分的方法,并且我们看到了两个可用于衡量预测质量的损失函数示例。但是我们如何有效地确定给出最佳(最低)损失的参数呢?这个过程就是优化,它是下一节的主题。
延伸阅读
这些读物是可选的,并且包含感兴趣的内容。
- Charlie Tang 2013 年的使用线性支持向量机进行深度学习提供了一些结果,声称 L2SVM 优于 Softmax。