卷积神经网络:网络架构、卷积层与池化层
本篇目录:
- 网络架构概览
- 卷积神经网络的层
- 卷积层
- 池化层
- 归一化层
- 全连接层
- 将全连接层转换为卷积层
- 卷积神经网络架构
- 层的组合方式
- 各层尺寸的设计规律
- 案例研究(LeNet / AlexNet / ZFNet / GoogLeNet / VGGNet)
- 计算量与内存开销
- 补充参考资料
卷积神经网络(CNN / ConvNet)
卷积神经网络与上一章中的普通神经网络非常相似:它们由具有可学习权重和偏置的神经元组成。每个神经元接收一些输入,执行点积,并按需要接上非线性激活函数。整个网络仍然表达单个可微得分函数:从一端的原始图像像素到另一端的类别得分。而且它们在最后(全连接)层仍然具有损失函数(例如 SVM/Softmax),并且我们为学习常规神经网络开发的所有提示/技巧仍然适用。
那么有什么变化呢? ConvNet 架构明确假设输入是图像,这允许我们将某些属性编码到架构中。这些使得前向函数的实现更加高效,并大大减少了网络中的参数数量。
网络架构概览
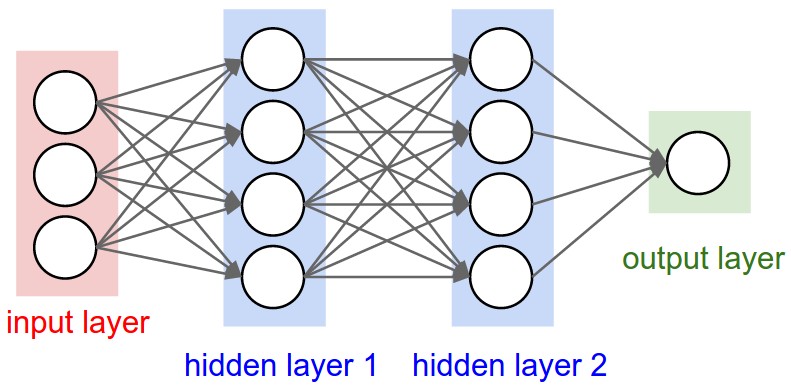
回想一下:常规神经网络。正如我们在上一章中看到的,神经网络接收输入(单个向量),并通过一系列隐藏层对其进行转换。每个隐藏层由一组神经元组成,其中每个神经元与前一层中的所有神经元完全连接,并且单层中的神经元完全独立运行,不共享任何连接。最后一个全连接层称为“输出层”,在分类设置中它代表类别得分。
常规神经网络不能很好地扩展到完整图像。在 CIFAR-10 中,图像的大小仅为 32x32x3(32 个宽、32 个高、3 个颜色通道),因此常规神经网络的第一个隐藏层中的单个全连接神经元将具有 32*32*3 = 3072 个权重。这个数量似乎仍然是可以管理的,但显然这种完全连接的结构无法扩展到更大的图像。例如,尺寸更合适的图像,例如200x200x3,将导致神经元具有 200*200*3 = 120,000 个权重。此外,我们几乎肯定希望有几个这样的神经元,因此参数会很快累加!显然,这种完全连接是浪费的,大量的参数很快就会导致过拟合。
3D 神经元张量。卷积神经网络利用了输入由图像组成的事实,并且它们以更合理的方式约束架构。特别是,与常规神经网络不同,ConvNet 的层具有按 3 个维度排列的神经元:宽度、高度、深度。 (请注意,这里的单词深度指的是激活张量的第三维,而不是完整神经网络的深度,后者可以指网络中的总层数。)例如,CIFAR-10中的输入图像是激活的输入张量,该张量的尺寸为32x32x3(分别为宽度、高度、深度)。正如我们很快就会看到的,一层中的神经元只会连接到其之前层的一小部分区域,而不是以完全连接的方式连接到所有神经元。此外,CIFAR-10 的最终输出层的尺寸为 1x1x10,因为在 ConvNet 架构结束时,我们将把完整图像简化为沿深度维度排列的单个类别得分向量。这是一个可视化:
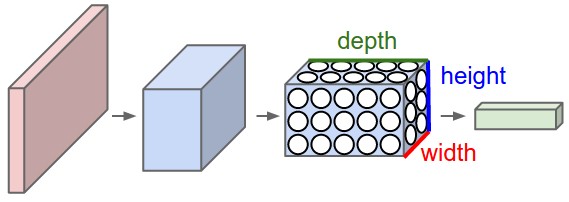
卷积网络由层组成。每个层都有一个简单的 API:它使用一些可能有参数或没有参数的可微函数将输入 3D 张量转换为输出 3D 张量。
卷积神经网络中的常用层
如上所述,简单的 ConvNet 是一系列层,ConvNet 的每一层都通过可微函数将一个激活值转换为另一个激活值。我们使用三种主要类型的层来构建 ConvNet 架构:卷积层、池化层和全连接层(与常规神经网络中完全相同)。我们将堆叠这些层以形成完整的 ConvNet 架构。
示例架构:概述。我们将在下面详细介绍,但用于 CIFAR-10 分类的简单 ConvNet 可以具有架构 [INPUT - CONV - RELU - POOL - FC]。更详细地说:
- INPUT [32x32x3] 将保存图像的原始像素值,在本例中图像的宽度为 32,高度为 32,并且具有三个颜色通道 R、G、B。
- CONV层将计算连接到输入中局部区域的神经元的输出,每个神经元计算它们的权重和它们连接到输入张量中的小区域之间的点积。如果我们决定使用 12 个滤波器,这可能会导致张量如 [32x32x12]。
- RELU 层将应用元素激活函数,例如 \\(max(0,x)\\) 阈值为零。这使得卷的大小保持不变 ([32x32x12])。
- POOL层将沿空间维度(宽度、高度)执行下采样操作,产生诸如[16x16x12]的张量。
- FC(即全连接)层将计算类别得分,产生大小为 [1x1x10] 的张量,其中 10 个数字中的每一个对应一个类别得分,例如 CIFAR-10 的 10 个类别中的分数。与普通神经网络一样,顾名思义,该层中的每个神经元都将连接到上一层张量中的所有数字。
通过这种方式,ConvNet 将原始图像从原始像素值逐层转换为最终的类别得分。请注意,某些层包含参数,而其他层则不包含。特别是,CONV/FC 层执行的变换不仅是输入张量中激活的函数,也是参数(神经元的权重和偏置)的函数。另一方面,RELU/POOL层将实现固定的功能。 CONV/FC 层中的参数将使用梯度下降进行训练,以便 ConvNet 计算的类别得分与每个图像的训练集中的标签一致。
总之:
- 在最简单的情况下,ConvNet 架构是一个将图像量转换为输出量的层列表(例如,保存类别得分)
- 有几种不同类型的层(例如 CONV/FC/RELU/POOL 是迄今为止最受欢迎的)
- 每层接受输入 3D 张量,并通过可微函数将其转换为输出 3D 张量
- 每层可能有也可能没有参数(例如 CONV/FC 有,RELU/POOL 没有)
- 每层可能有也可能没有额外的超参数(例如 CONV/FC/POOL 有,RELU 没有)
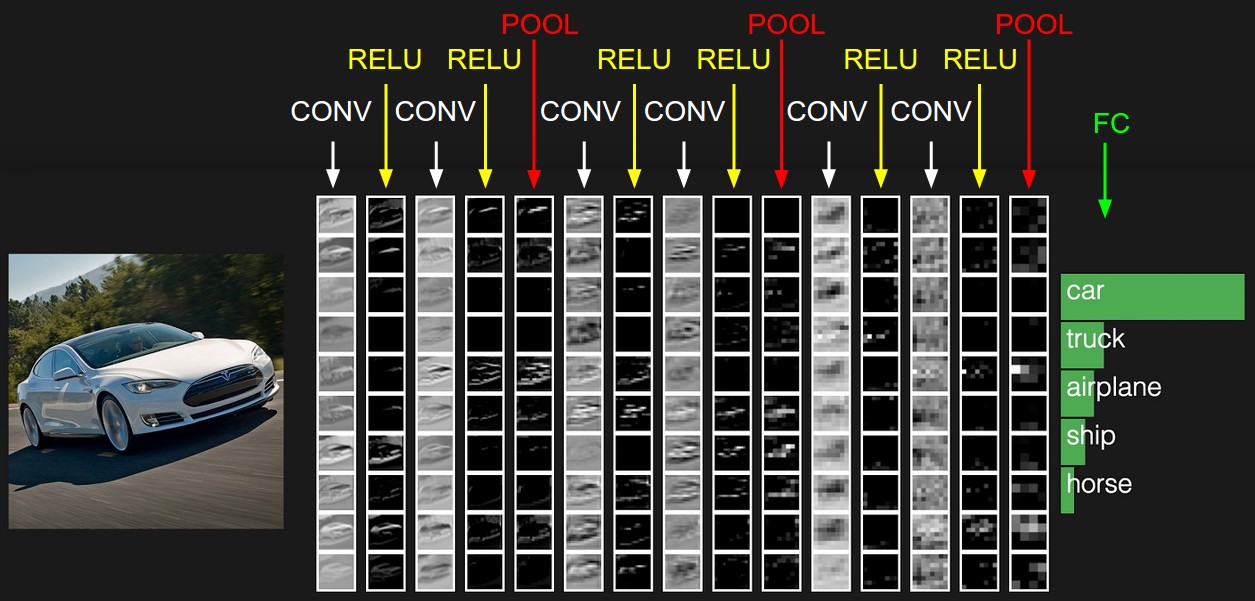
我们现在描述各个层及其超参数及其连接的详细信息。
卷积层
卷积层是卷积网络的核心构建块,负责完成大部分计算繁重工作。
从计算过程直观理解卷积。先不借助大脑或神经元的类比,直接看卷积层(CONV)的计算。卷积层的参数是一组可学习的滤波器。每个滤波器在空间维度(宽和高)上都很小,但会覆盖输入的全部通道。例如,第一层的滤波器可以是 5x5x3:宽和高各为 5 个像素,最后的 3 对应图像的三个颜色通道。前向传播时,滤波器沿输入的宽、高方向滑动,并在每个位置与对应输入区域做点积。这样,每个滤波器都会生成一张二维激活图,记录它在各空间位置的响应。直观地说,网络会学到能够响应特定视觉特征的滤波器:浅层可能响应某个方向的边缘或某种颜色的斑块,高层则可能响应完整的蜂窝或车轮状图案。每个卷积层包含一组这样的滤波器,例如 12 个;它们分别生成二维激活图,再沿通道维度堆叠为输出张量。
大脑视图。如果您喜欢大脑/神经元类比,那么 3D 输出张量中的每个条目也可以解释为神经元的输出,该神经元仅查看输入中的一小部分区域,并与空间上左侧和右侧的所有神经元共享参数(因为这些数字都是应用相同滤波器的结果)。
我们现在讨论神经元连接的细节、它们在空间中的排列以及它们的参数共享方案。
局部连接。对于图像这样的高维输入,让每个神经元与上一层的全部神经元连接并不现实。因此,每个神经元只连接输入张量中的一个局部区域。该区域在空间上的大小是一个超参数,称为神经元的感受野,这里也就是滤波器的空间尺寸。连接在深度方向上的范围始终覆盖输入的全部通道。需要区分这两种处理方式:在宽、高构成的二维空间中采用局部连接,在通道方向上则采用完整连接。
示例 1。例如,假设输入张量的大小为 [32x32x3](例如 RGB CIFAR-10 图像)。如果感受野(或滤波器大小)为 5x5,则卷积层中的每个神经元将具有输入张量中 [5x5x3] 区域的权重,总共 5*5*3 = 75 个权重(和 +1 个偏置参数)。请注意,沿深度轴的连接范围必须为 3,因为这是输入张量的深度。
示例 2。假设输入张量的大小为 [16x16x20]。然后使用 3x3 的感受野大小示例,Conv 层中的每个神经元现在总共有 3*3*20 = 180 个与输入张量的连接。请再次注意,连接在 2D 空间(例如 3x3)中是局部的,但沿输入深度 (20) 是完整的。
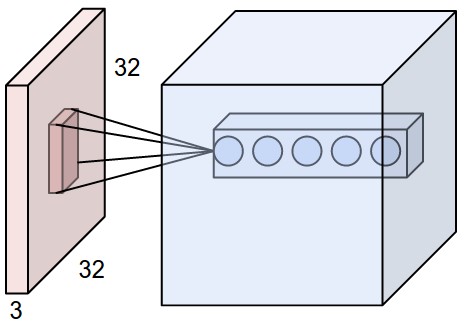
空间排列。我们已经解释了Conv层中每个神经元与输入张量的连接,但我们还没有讨论输出张量中有多少个神经元或者它们是如何排列的。三个超参数控制输出张量的大小:深度、步长和零填充。 We discuss these next:
- 首先,输出张量的深度是一个超参数,这里的深度指输出通道数,也就是使用的滤波器数量;不同滤波器会学习寻找输入中的不同特征。例如,第一层卷积接收原始图像时,同一空间位置上不同通道的神经元,可能分别对不同方向的边缘或不同颜色的色块产生响应。我们将所有观察输入同一区域、沿深度方向排列的神经元称为深度列,也有人称其为纤维(fibre)。
- 其次,我们必须指定滑动滤波器的步幅。当步长为 1 时,我们一次移动滤波器一个像素。当步长为 2(或不常见的 3 或更多,尽管这在实践中很少见)时,当我们滑动滤波器时,滤波器一次跳跃 2 个像素。这将在空间上产生较小的输出量。
- 正如我们很快就会看到的,有时在输入张量的边界周围填充零会很方便。此零填充的大小是一个超参数。零填充的一个很好的功能是,它允许我们控制输出张量的空间大小(最常见的是,我们很快就会看到,我们将使用它来精确保留输入张量的空间大小,以便输入和输出的宽度和高度相同)。
我们可以计算输出张量的空间大小,作为输入张量大小(\\(W\\))、卷积层神经元的感受野大小(\\(F\\))、应用它们的步幅(\\(S\\))以及边界上使用的零填充量(\\(P\\))的函数。可以自行验证,计算“适合”的神经元数量的正确公式由 \\((W - F + 2P)/S + 1\\) 给出。例如,对于 7x7 输入和步幅为 1、pad 0 的 3x3 滤波器,我们将得到 5x5 输出。如果步幅为 2,我们将得到 3x3 的输出。我们还可以再看一个图形示例:
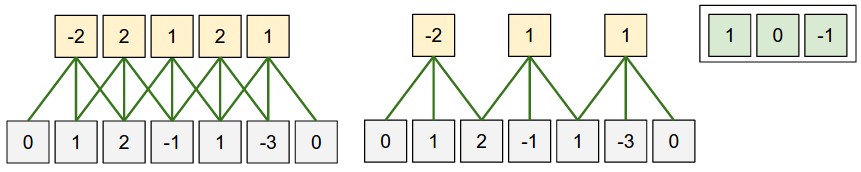
在此示例中,神经元权重为 [1,0,-1](如最右侧所示),其偏置为零。这些权重在所有黄色神经元之间共享(请参阅下面的参数共享)。
使用零填充。在上面左侧的示例中,请注意输入维度为 5,输出维度也相等:也是 5。这是因为我们的感受野为 3,并且我们使用的零填充为 1。如果没有使用零填充,那么输出张量的空间维度将仅为 3,因为这就是有多少神经元将“适合”原始输入。一般来说,当步长为 \\(S = 1\\) 时,将零填充设置为 \\(P = (F - 1)/2\\) 可确保输入张量和输出张量在空间上具有相同的大小。以这种方式使用零填充是很常见的,当我们更多地讨论 ConvNet 架构时,我们将讨论完整的原因。
步幅限制。再次注意,空间排列超参数具有相互约束。例如,当输入的大小为\\(W = 10\\),不使用零填充\\(P = 0\\),并且滤波器大小为\\(F = 3\\)时,则不可能使用步长\\(S = 2\\),因为\\((W - F + 2P)/S + 1 = (10 - 3 + 0) / 2 + 1 = 4.5\\),即不是整数,表明神经元没有整齐地“拟合”,并且在输入端对称。因此,超参数的这种设置被认为是无效的,ConvNet 库可能会抛出异常或对其余部分进行零填充以使其适合,或者裁剪输入以使其适合,等等。正如我们将在 ConvNet 架构部分中看到的那样,适当调整 ConvNet 的大小以使所有维度都“有效”可能是一个真正令人头痛的问题,而使用零填充和一些设计指南将显着缓解这一问题。
真实示例。 Krizhevsky 等人在 2012 年赢得 ImageNet 挑战赛的架构接受了尺寸为 [227x227x3] 的图像。在第一个卷积层上,它使用感受野大小为 \\(F = 11\\)、步幅为 \\(S = 4\\) 且无零填充 \\(P = 0\\) 的神经元。由于 (227 - 11)/4 + 1 = 55,并且由于 Conv 层的深度为 \\(K = 96\\),因此 Conv 层输出张量的大小为 [55x55x96]。该张量中的每个 55*55*96 个神经元都连接到输入张量中大小为 [11x11x3] 的区域。此外,每个深度列中的所有 96 个神经元都连接到输入的相同 [11x11x3] 区域,但当然具有不同的权重。有趣的是,如果你阅读实际的论文,它声称输入图像是 224x224,这肯定是不正确的,因为 (224 - 11)/4 + 1 显然不是整数。这让 ConvNets 历史上的许多人感到困惑,并且对发生的事情知之甚少。我自己的最佳猜测是 Alex 使用了 3 个额外像素的零填充,但他在论文中没有提到这一点。
参数共享。参数共享方案用于卷积层中来控制参数的数量。使用上面的实际示例,我们看到第一个卷积层中有 55*55*96 = 290,400 个神经元,每个神经元有 11*11*3 = 363 个权重和 1 个偏置。仅 ConvNet 第一层上的参数加起来就达到了 290400 * 364 = 105,705,600 个参数。显然,这个数字非常高。
通过一个合理假设,可以大幅减少参数:如果某种特征在空间位置 (x,y) 上值得检测,那么它在另一位置 (x2,y2) 上也应该值得检测。把固定一个通道后得到的二维切片称为通道切片,例如 [55x55x96] 的张量包含 96 个 [55x55] 切片;我们让每个切片内的所有神经元使用同一组权重和偏置。这样,示例中的第一卷积层只需 96 组权重,每个切片一组,共 96*11*11*3 = 34,848 个权重,加上 96 个偏置后共有 34,944 个参数。也就是说,每个切片中的 55*55 个神经元共享参数。反向传播时,先计算各神经元对共享权重的梯度贡献,再在同一切片内求和,用来更新该切片唯一的一组权重。
请注意,如果单个通道切片中的所有神经元都使用相同的权重向量,则每个通道切片中 CONV 层的前向传播可以计算为神经元权重与输入张量的卷积(因此得名:卷积层)。这就是为什么通常将权重集称为与输入进行卷积的滤波器(或卷积核)。
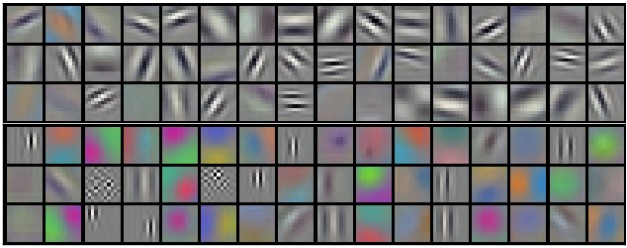
请注意,有时参数共享假设可能没有意义。当 ConvNet 的输入图像具有某些特定的中心结构时尤其如此,例如,我们应该期望在图像的一侧学习到与另一侧完全不同的特征。一个实际的例子是当输入是图像居中的脸部时。您可能期望可以(并且应该)在不同的空间位置学习不同的眼睛特定或头发特定特征。在这种情况下,通常会放宽参数共享方案,而只是将该层称为局部连接层。
Numpy 示例。为了使上面的讨论更加具体,让我们通过代码和具体示例来表达相同的想法。假设输入张量是一个 numpy 数组 X。然后:
- 位置
(x,y)处的深度列(或光纤)将是激活X[x,y,:]。 - 深度
d处的通道切片,或等效的激活图将是激活X[:,:,d]。
卷积层示例。假设输入张量 X 的形状为 X.shape: (11,11,4)。进一步假设我们不使用零填充 (\\(P = 0\\)),滤波器大小为 \\(F = 5\\),步长为 \\(S = 2\\)。因此,输出张量的空间大小为 (11-5)/2+1 = 4,张量的宽度和高度均为 4。输出张量中的激活图(称为 V)将如下所示(本示例中仅计算了部分元素):
V[0,0,0] = np.sum(X[:5,:5,:] * W0) + b0V[1,0,0] = np.sum(X[2:7,:5,:] * W0) + b0V[2,0,0] = np.sum(X[4:9,:5,:] * W0) + b0V[3,0,0] = np.sum(X[6:11,:5,:] * W0) + b0
请记住,在 numpy 中,上面的操作 * 表示数组之间的元素乘法。另请注意,权重向量 W0 是该神经元的权重向量,b0 是偏置。这里,假设 W0 的形状为 W0.shape: (5,5,4),因为滤波器大小为 5,输入张量的深度为 4。请注意,在每个点,我们都在计算点积,如之前在普通神经网络中看到的那样。此外,我们看到我们使用相同的权重和偏置(由于参数共享),并且沿宽度的尺寸以 2 为步长(即步幅)增加。要在输出张量中构造第二个激活图,我们需要:
V[0,0,1] = np.sum(X[:5,:5,:] * W1) + b1V[1,0,1] = np.sum(X[2:7,:5,:] * W1) + b1V[2,0,1] = np.sum(X[4:9,:5,:] * W1) + b1V[3,0,1] = np.sum(X[6:11,:5,:] * W1) + b1V[0,1,1] = np.sum(X[:5,2:7,:] * W1) + b1(沿着 y 的示例)V[2,3,1] = np.sum(X[4:9,6:11,:] * W1) + b1(或两者)
我们看到我们正在索引 V 中的第二个深度维度(在索引 1 处),因为我们正在计算第二个激活图,并且现在使用了一组不同的参数 (W1)。在上面的示例中,为了简洁起见,我们省略了卷积层为填充输出数组 V 的其他部分而执行的一些其他操作。此外,请记住,这些激活图通常通过 ReLU 等激活函数按元素进行跟踪,但此处未显示。
摘要。总而言之,Conv 层:
- 接受大小为 \\(W_1 \times H_1 \times D_1\\) 的卷
- 需要四个超参数:
- 滤波器数量\\(K\\),
- 它们的空间范围\\(F\\),
- 步幅\\(S\\),
- 零填充量 \\(P\\)。
- 生成大小为 \\(W_2 \times H_2 \times D_2\\) 的卷,其中:
- \\(W_2 = (W_1 - F + 2P)/S + 1\\)
- \\(H_2 = (H_1 - F + 2P)/S + 1\\) (即宽度和高度通过对称性相等计算)
- \\(D_2 = K\\)
- 通过参数共享,它为每个滤波器引入了 \\(F \cdot F \cdot D_1\\) 权重,总共 \\((F \cdot F \cdot D_1) \cdot K\\) 权重和 \\(K\\) 偏置。
- 在输出张量中,第 \\(d\\) 个通道切片(大小为 \\(W_2 \times H_2\\))是在输入张量上执行第 \\(d\\) 滤波器的有效卷积的结果,步长为 \\(S\\),然后偏移 \\(d\\) 个偏置。
超参数的常见设置是 \\(F = 3, S = 1, P = 1\\)。然而,有一些共同的约定和经验规则来激发这些超参数。请参阅下面的ConvNet 架构部分。
卷积演示。下面是 CONV 层的运行演示。由于 3D 张量很难可视化,因此所有张量(输入张量(蓝色)、权重张量(红色)、输出张量(绿色))都以每个通道切片成行堆叠的方式可视化。输入张量的大小为\\(W_1 = 5, H_1 = 5, D_1 = 3\\),CONV层参数为\\(K = 2, F = 3, S = 2, P = 1\\)。也就是说,我们有两个大小为 \\(3 \times 3\\) 的滤波器,它们的步长为 2。因此,输出张量大小的空间大小为 (5 - 3 + 2)/2 + 1 = 3。此外,请注意,对输入张量应用了 \\(P = 1\\) 的填充,使输入张量的外边界为零。下面的可视化迭代输出激活(绿色),并显示每个元素是通过将突出显示的输入(蓝色)与滤波器(红色)按元素相乘、求和,然后用偏置偏移结果来计算的。
作为矩阵乘法实现。请注意,卷积运算本质上是在滤波器和输入的局部区域之间执行点积。 CONV 层的一种常见实现模式是利用这一事实,并将卷积层的前向传播公式化为一个大矩阵乘法,如下所示:
- 输入图像中的局部区域在通常称为 im2col 的操作中拉伸成列。例如,如果输入为 [227x227x3],并且要以步长 4 与 11x11x3 滤波器进行卷积,那么我们将在输入中获取 [11x11x3] 个像素块,并将每个块拉伸为大小为 11*11*3 = 363 的列向量。在输入中以步长 4 迭代此过程会得到 (227-11)/4+1 = 55 个位置沿着宽度和高度,得到一个大小为 [363 x 3025] 的 im2col 的输出矩阵
X_col,其中每一列都是一个延伸的感受野,总共有 55*55 = 3025 个。请注意,由于感受野重叠,输入张量中的每个数字可能会在多个不同的列中重复。 - CONV 层的权重同样被拉伸成行。例如,如果有 96 个大小为 [11x11x3] 的滤波器,则将给出大小为 [96 x 363] 的矩阵
W_row。 - 卷积的结果现在相当于执行一个大型矩阵乘法
np.dot(W_row, X_col),它评估每个滤波器和每个感受野位置之间的点积。在我们的示例中,此操作的输出将为 [96 x 3025],给出每个位置处每个滤波器的点积的输出。 - 最后必须将结果重新整形回其正确的输出尺寸 [55x55x96]。
这种方法的缺点是它会使用大量内存,因为输入张量中的某些值在 X_col 中被复制多次。然而,好处是我们可以利用许多非常有效的矩阵乘法实现(例如,在常用的 BLAS API 中)。此外,可以重用相同的 im2col 想法来执行池化操作,我们接下来将讨论这一点。
反向传播。卷积运算的反向传播(对于数据和权重)也是卷积(但具有空间翻转的滤波器)。在一维情况下,通过一个玩具示例(现在不展开)很容易得出这一点。
1x1 卷积。顺便说一句,有几篇论文使用了 1x1 卷积,正如网络中的网络首先研究的那样。有些人一开始对 1x1 卷积感到困惑,尤其是当他们有信号处理背景时。通常信号是二维的,因此 1x1 卷积没有意义(它只是逐点缩放)。然而,在卷积网络中,情况并非如此,因为我们必须记住,我们在 3 维张量上进行操作,并且滤波器始终延伸到输入张量的整个深度。例如,如果输入是 [32x32x3],那么进行 1x1 卷积实际上就是进行 3 维点积(因为输入深度是 3 个通道)。
空洞卷积。另一项进展是在卷积层中加入空洞间隔这一超参数,参见 Fisher Yu 与 Vladlen Koltun 的论文。前面讨论的滤波器都在连续位置取值;空洞卷积则允许相邻取值位置之间留出间隔。例如,一维滤波器 w 的大小为 3,作用于输入 x 时,普通卷积计算 w[0]*x[0] + w[1]*x[1] + w[2]*x[2]。按本文的计数方式,这对应间隔 0;间隔为 1 时,则计算 w[0]*x[0] + w[1]*x[2] + w[2]*x[4],即相邻取值位置之间跳过一个元素。将这种滤波器与无间隔滤波器搭配,可以用较少的层汇集更大空间范围内的信息。例如,连续堆叠两个 3x3 卷积层,第二层的神经元会依赖原始输入中的 5x5 区域,其有效感受野为 5x5。使用空洞卷积时,有效感受野能够更快扩大。
池化层
在 ConvNet 架构中,定期在连续的 Conv 层之间插入池化层是很常见的。其功能是逐步减小表示的空间大小,以减少网络中的参数量和计算量,从而控制过拟合。池化层在输入的每个通道切片上独立运行,并使用 MAX 操作在空间上调整其大小。最常见的形式是池化层,其大小为 2x2 的滤波器应用了 2 步长,将输入中的每个通道切片沿宽度和高度向下采样 2,丢弃 75% 的激活。在这种情况下,每个 MAX 操作都会取 4 个数字的最大值(某个通道切片中的小 2x2 区域)。深度尺寸保持不变。更一般地说,池化层:
- 接受大小为 \\(W_1 \times H_1 \times D_1\\) 的卷
- 需要两个超参数:
- 它们的空间范围\\(F\\),
- 步幅\\(S\\),
- 生成大小为 \\(W_2 \times H_2 \times D_2\\) 的卷,其中:
- \\(W_2 = (W_1 - F)/S + 1\\)
- \\(H_2 = (H_1 - F)/S + 1\\)
- \\(D_2 = D_1\\)
- 引入零参数,因为它计算输入的固定函数
- 对于池化层,使用零填充来填充输入的情况并不常见。
值得注意的是,在实践中发现的最大池化层只有两种常见的变体:带有\\(F = 3, S = 2\\)(也称为重叠池化)的池化层,以及更常见的\\(F = 2, S = 2\\)。具有较大感受野的池化尺寸破坏性太大。
其他池化方式。除了最大池化,池化单元也可以执行其他运算,例如平均池化或 L2 范数池化。平均池化在早期较为常见;相较之下,最大池化在实践中表现更好,因此后来得到更多采用。
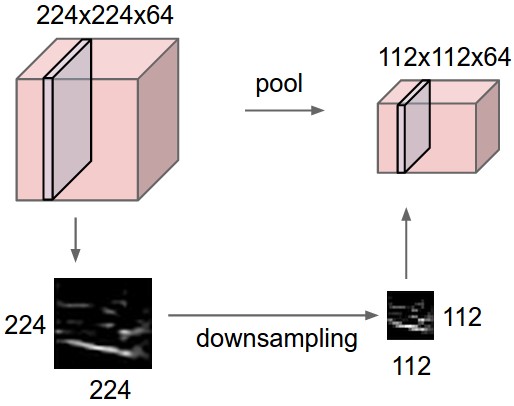
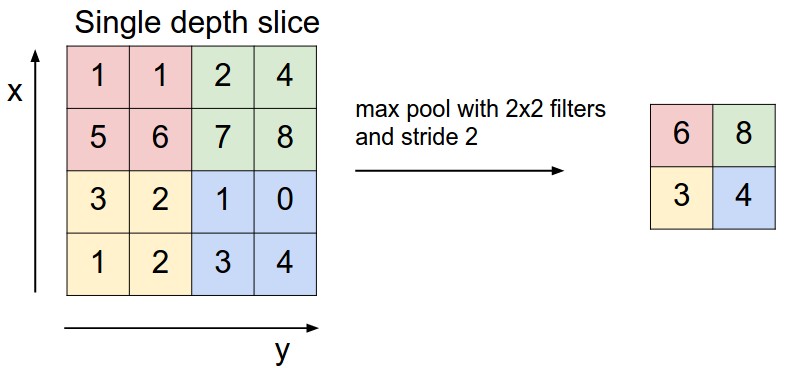
反向传播。回想一下反向传播章节,max(x, y) 操作的反向传播有一个简单的解释:仅将梯度路由到前向传播中具有最高值的输入。因此,在池化层的前向传播过程中,通常会跟踪最大激活的索引(有时也称为开关),以便梯度路由在反向传播期间高效。
取消池化层。一些研究者认为可以不使用池化操作。例如,《追求简洁:全卷积网络》提出只重复堆叠卷积层,并在需要缩小特征图时使用较大步幅的卷积。取消池化层也被发现有助于训练变分自编码器(VAE)、生成对抗网络(GAN)等生成模型。原文据此推测,未来的网络可能只保留很少的池化层,甚至完全不用池化层。
归一化层
许多类型的归一化层已被提议用于 ConvNet 架构,有时是为了实现在生物大脑中观察到的抑制方案。然而,这些层已经失宠,因为在实践中它们的贡献被证明是最小的(如果有的话)。有关各种类型的标准化,请参阅 Alex Krizhevsky 的 cuda-convnet 库 API 中的讨论。
全连接层
全连接层中的神经元与前一层中的所有激活具有完全连接,如常规神经网络中所示。因此,它们的激活可以通过矩阵乘法和偏置偏移来计算。有关详细信息,请参阅注释的神经网络部分。
将 FC 层转换为 CONV 层
值得注意的是,FC 层和 CONV 层之间的唯一区别在于 CONV 层中的神经元仅连接到输入中的局部区域,并且 CONV 张量中的许多神经元共享参数。然而,两层中的神经元仍然计算点积,因此它们的功能形式是相同的。因此,事实证明 FC 层和 CONV 层之间可以进行转换:
- 对于任何 CONV 层,都有一个实现相同前向功能的 FC 层。权重矩阵将是一个大矩阵,除了某些块(由于局部连接性)之外,大部分为零,其中许多块中的权重相等(由于参数共享)。
- 相反,任何 FC 层都可以转换为 CONV 层。例如,具有 \\(K = 4096\\) 的 FC 层正在查看大小为 \\(7 \times 7 \times 512\\) 的某个输入张量,可以等效地表示为具有 \\(F = 7, P = 0, S = 1, K = 4096\\) 的 CONV 层。换句话说,我们将滤波器大小设置为输入张量的大小,因此输出将只是 \\(1 \times 1 \times 4096\\),因为只有一个深度列“适合”整个输入张量,给出与初始 FC 层相同的结果。
FC->CONV 转换。在这两种转换中,将 FC 层转换为 CONV 层的能力在实践中特别有用。考虑一个 ConvNet 架构,它采用 224x224x3 图像,然后使用一系列 CONV 层和 POOL 层将图像减小到大小为 7x7x512 的激活张量(在我们稍后将看到的 AlexNet 架构中,这是通过使用 5 个池化层来完成的,这些池化层每次将输入空间下采样两倍,从而形成最终的空间大小224/2/2/2/2/2 = 7)。从这里开始,AlexNet 使用两个大小为 4096 的 FC 层,最后使用具有 1000 个神经元的最后一个 FC 层来计算类别得分。我们可以将这三个 FC 层中的每一个转换为 CONV 层,如上所述:
- 将查看 [7x7x512] 张量的第一个 FC 层替换为使用滤波器大小 \\(F = 7\\) 的 CONV 层,给出输出张量 [1x1x4096]。
- 将第二个 FC 层替换为使用滤波器大小 \\(F = 1\\) 的 CONV 层,给出输出量 [1x1x4096]
- 类似地用 \\(F=1\\) 替换最后一个 FC 层,给出最终输出 [1x1x1000]
实际上,这些转换中的每一个都可能涉及将每个 FC 层中的权重矩阵 \\(W\\) 操纵(例如重塑)到 CONV 层滤波器中。事实证明,这种转换允许我们在一次前向传播中非常有效地“滑动”原始 ConvNet 跨越较大图像中的许多空间位置。
例如,224×224 的图像经前面的网络得到 [7×7×512] 张量,相当于空间尺寸缩小 32 倍。将 384×384 图像输入转换后的架构,会在同一位置得到 [12×12×512],因为 384/32 = 12。再经过由全连接层转换而来的 3 个卷积层,最终得到 [6×6×1000],因为 (12−7)/1+1 = 6。输出因此不再只是一个 [1×1×1000] 类别得分向量,而是在整张 384×384 图像上分布的 6×6 组类别得分。
以 32 像素为步长,在 384x384 图像的 224x224 裁剪中独立评估原始 ConvNet(带有 FC 层),得到的结果与转发转换后的 ConvNet 一次相同。
当然,单次转发转换后的 ConvNet 比在所有这 36 个位置上迭代原始 ConvNet 效率更高,因为 36 个评估共享计算。这个技巧在实践中经常被用来获得更好的性能,例如,通常会调整图像大小以使其更大,使用转换后的 ConvNet 来评估许多空间位置的类别得分,然后对类别得分进行平均。
最后,如果我们想在图像上有效地应用原始 ConvNet,但步幅小于 32 像素怎么办?我们可以通过多次前传来实现这一点。例如,请注意,如果我们想要使用 16 像素的步长,我们可以通过组合转发转换后的 ConvNet 两次接收到的张量来实现这一点:第一次在原始图像上,第二次在图像上,但图像沿宽度和高度在空间上移动 16 个像素。
- Net Surgery 上的 IPython Notebook 展示了如何在实践中用代码(使用 Caffe)执行转换
卷积神经网络架构
我们已经看到,卷积网络通常仅由三层类型组成:CONV、POOL(除非另有说明,我们假设为最大池)和 FC(全连接的缩写)。我们还将显式地将 RELU 激活函数写为一个层,它应用了元素非线性。在本节中,我们讨论如何将它们通常堆叠在一起以形成整个卷积网络。
层的组合方式
ConvNet 架构最常见的形式是堆叠一些 CONV-RELU 层,后面是 POOL 层,并重复此模式,直到图像在空间上合并为小尺寸。在某些时候,过渡到全连接层是很常见的。最后一个全连接层保存输出,例如类别得分。换句话说,最常见的 ConvNet 架构遵循以下模式:
INPUT -> [[CONV -> RELU]*N -> POOL?]*M -> [FC -> RELU]*K -> FC
其中*表示重复,POOL?表示可选池化层。此外,N >= 0(通常为N <= 3)、M >= 0、K >= 0(通常为K < 3)。例如,以下是您可能会看到的一些遵循此模式的常见 ConvNet 架构:
INPUT -> FC,实现线性分类器。这里是N = M = K = 0。INPUT -> CONV -> RELU -> FCINPUT -> [CONV -> RELU -> POOL]*2 -> FC -> RELU -> FC。在这里我们看到每个 POOL 层之间都有一个 CONV 层。INPUT -> [CONV -> RELU -> CONV -> RELU -> POOL]*3 -> [FC -> RELU]*2 -> FC这里我们看到每个 POOL 层之前堆叠了两个 CONV 层。对于更大和更深的网络来说,这通常是一个好主意,因为多个堆叠的 CONV 层可以在破坏性池化操作之前开发输入张量的更复杂的特征。
优先堆叠多个小卷积核,而不是使用一个大感受野的卷积层。假设连续堆叠三个 3x3 卷积层,并在层间加入非线性激活。第一层神经元看到原始输入的 3x3 区域;第二层看到第一层的 3x3 区域,对应原始输入的 5x5 区域;第三层则对应原始输入的 7x7 区域。如果改用单个 7x7 卷积层,虽然空间感受野相同,但有两点不足。首先,单个卷积只对输入进行线性计算,而三层卷积之间的非线性使特征表示更加丰富。其次,假设各层都有 \\(C\\) 个通道,单个 7x7 卷积层包含 \\(C \times (7 \times 7 \times C) = 49 C^2\\) 个参数,三个 3x3 卷积层却只需 \\(3 \times (C \times (3 \times 3 \times C)) = 27 C^2\\) 个参数。因此,堆叠小卷积核可以用更少参数表示更强的特征。代价是反向传播时需要保存更多中间层的计算结果,可能占用更多内存。
最近的变化。应该指出的是,线性层列表的传统范例最近在 Google 的 Inception 架构以及微软亚洲研究院当前(最先进的)残差网络中受到了挑战。这两者(请参阅下面案例研究部分的详细信息)都具有更复杂和不同的连接结构。
实践中:使用在 ImageNet 上最有效的方法。如果您在考虑架构决策时感到有点疲劳,您会很高兴知道在 90% 或更多的应用程序中您不必担心这些。我喜欢将这一点总结为“不要成为英雄”:您应该查看当前在 ImageNet 上最有效的架构,下载预训练的模型并根据您的数据对其进行微调,而不是滚动自己的架构来解决问题。您很少需要从头开始训练 ConvNet 或从头开始设计 ConvNet。我也在深度学习学校中提出了这一点。
各层尺寸的设计规律
到目前为止,我们都忽略了 ConvNet 中每个层使用的常见超参数。我们将首先陈述确定架构大小的通用经验规则,然后遵循这些规则并讨论符号:
输入层(包含图像)应该可以被 2 整除很多次。常见的数字包括 32(例如 CIFAR-10)、64、96(例如 STL-10)或 224(例如常见的 ImageNet ConvNet)、384 和 512。
卷积层宜采用小卷积核,例如 3x3、最多 5x5,并使用步幅 \\(S = 1\\)。关键是适当补零,使卷积前后的空间尺寸保持一致:\\(F = 3\\) 时取 \\(P = 1\\);\\(F = 5\\) 时取 \\(P = 2\\)。一般而言,对大小为 \\(F\\) 的卷积核,使用 \\(P = (F - 1) / 2\\) 的填充可以保留输入尺寸。如果必须使用 7x7 等较大的卷积核,通常将其放在直接处理原始图像的第一卷积层。
池层负责对输入的空间维度进行下采样。最常见的设置是使用具有 2x2 感受野(即 \\(F = 2\\))和步幅为 2(即 \\(S = 2\\))的最大池化。请注意,这会丢弃输入张量中 75% 的激活(由于宽度和高度均下采样 2)。另一个不太常见的设置是使用步幅为 2 的 3x3 感受野,但这使得“拟合”更加复杂(例如,32x32x3 层需要零填充才能与具有 3x3 感受野和步幅 2 的最大池化层一起使用)。最大池化的感受野大小大于 3 的情况非常罕见,因为池化的损耗太大且过于激进。这通常会导致性能更差。
减少大小调整的麻烦。上面提出的方案是令人满意的,因为所有 CONV 层都保留其输入的空间大小,而 POOL 层单独负责对张量进行空间下采样。在我们使用大于 1 的步幅或不对 CONV 层中的输入进行零填充的替代方案中,我们必须非常仔细地跟踪整个 CNN 架构中的输入张量,并确保所有步幅和滤波器“正常工作”,并且 ConvNet 架构良好且对称地连接。
为什么在 CONV 中使用步幅为 1? 在实践中步幅越小效果越好。此外,正如已经提到的,步长 1 允许我们将所有空间下采样留给 POOL 层,而 CONV 层仅对输入张量进行深度变换。
为什么要使用填充?除了前面提到的在 CONV 后保持空间大小恒定的好处之外,这样做实际上还可以提高性能。如果 CONV 层不对输入进行零填充,而仅执行有效的卷积,那么在每次 CONV 后,张量的大小会少量减小,并且边界处的信息将被“冲走”得太快。
基于内存限制进行妥协。在某些情况下(尤其是在 ConvNet 架构的早期),根据上面介绍的经验规则,内存量可以非常快速地增加。例如,使用三个 3x3 CONV 层(每个层有 64 个滤波器且填充 1)过滤 224x224x3 图像将创建三个大小为 [224x224x64] 的激活张量。这总计约 1000 万次激活,或 72MB 内存(每个图像,用于激活和梯度)。由于 GPU 经常受到内存瓶颈的影响,因此可能需要做出妥协。在实践中,人们更喜欢只在网络的第一个 CONV 层做出妥协。例如,一个折衷方案可能是使用滤波器尺寸为 7x7、步幅为 2 的第一个 CONV 层(如 ZF 网络中所示)。作为另一个示例,AlexNet 使用大小为 11x11 的滤波器和 4 的步幅。
案例研究
卷积网络领域有多种具有名称的架构。最常见的是:
- LeNet。卷积网络的第一个成功应用是由 Yann LeCun 在 1990 年代开发的。其中,最著名的是用于读取邮政编码、数字等的 LeNet 架构。
- AlexNet。推动卷积网络在计算机视觉领域广泛应用的标志性工作是 Alex Krizhevsky、Ilya Sutskever 和 Geoff Hinton 提出的 AlexNet。它在 2012 年的 ImageNet ILSVRC 挑战赛中显著领先,Top-5 错误率约为 16%,相比之下亚军约为 26%。它与 LeNet 的架构相似,但规模更大、层数更多,并连续堆叠卷积层;此前常见的做法是每个卷积层后立即接一个池化层。
- 采埃孚网络。 ILSVRC 2013 的获胜者是 Matthew Zeiler 和 Rob Fergus 的卷积网络。它被称为 ZFNet(Zeiler & Fergus Net 的缩写)。它是对 AlexNet 的改进,通过调整架构超参数,特别是通过扩展中间卷积层的大小并使第一层的步幅和滤波器大小更小。
- GoogLeNet。 ILSVRC 2014 的获胜者是来自 Google 的 Szegedy 等人的卷积网络。它的主要贡献是开发了一个Inception Module,该模块大大减少了网络中参数的数量(4M,而 AlexNet 为 60M)。此外,本文在 ConvNet 顶部使用平均池化而不是全连接层,消除了大量看似无关紧要的参数。 GoogLeNet 还有几个后续版本,最近的是 Inception-v4。
- VGGNet。 2014 年 ILSVRC 亚军是由 Karen Simonyan 和 Andrew Zisserman 设计的网络,后来被称为 VGGNet。它的主要贡献在于表明网络深度是良好性能的关键组成部分。他们最终的最佳网络包含 16 个 CONV/FC 层,并且具有极其同质的架构,从头到尾仅执行 3x3 卷积和 2x2 池化,这一点很吸引人。他们的预训练模型可在 Caffe 中即插即用。 VGGNet 的缺点是评估代价更高,并且使用更多的内存和参数(140M)。这些参数大部分都在第一个全连接层中,后来发现可以在不降低性能的情况下删除这些全连接层,从而显着减少了必要参数的数量。
- ResNet。何恺明等人提出的残差网络赢得了 ILSVRC 2015 冠军。它采用特殊的跳跃连接,并广泛使用批归一化,也不再在末端堆叠传统的全连接层。可参阅何恺明的报告(视频、幻灯片)以及在 Torch 中复现网络的相关实验。原文截至 2016 年 5 月 10 日将 ResNet 视为当时领先的卷积网络和实践中的默认选择。还可参阅 2016 年 3 月发表的后续工作《深度残差网络中的恒等映射》,了解对原始架构的进一步改进。
VGGNet 详细信息。 让我们以案例研究的形式更详细地分解 VGGNet。整个 VGGNet 由 CONV 层和 POOL 层组成,CONV 层执行步长 1 和 pad 1 的 3x3 卷积,POOL 层执行步长 2(且无填充)的 2x2 最大池化。我们可以在处理的每个步骤写出表示的大小,并跟踪表示的大小和权重的总数:
INPUT: [224x224x3]        memory:  224*224*3=150K   weights: 0
CONV3-64: [224x224x64]  memory:  224*224*64=3.2M   weights: (3*3*3)*64 = 1,728
CONV3-64: [224x224x64]  memory:  224*224*64=3.2M   weights: (3*3*64)*64 = 36,864
POOL2: [112x112x64]  memory:  112*112*64=800K   weights: 0
CONV3-128: [112x112x128]  memory:  112*112*128=1.6M   weights: (3*3*64)*128 = 73,728
CONV3-128: [112x112x128]  memory:  112*112*128=1.6M   weights: (3*3*128)*128 = 147,456
POOL2: [56x56x128]  memory:  56*56*128=400K   weights: 0
CONV3-256: [56x56x256]  memory:  56*56*256=800K   weights: (3*3*128)*256 = 294,912
CONV3-256: [56x56x256]  memory:  56*56*256=800K   weights: (3*3*256)*256 = 589,824
CONV3-256: [56x56x256]  memory:  56*56*256=800K   weights: (3*3*256)*256 = 589,824
POOL2: [28x28x256]  memory:  28*28*256=200K   weights: 0
CONV3-512: [28x28x512]  memory:  28*28*512=400K   weights: (3*3*256)*512 = 1,179,648
CONV3-512: [28x28x512]  memory:  28*28*512=400K   weights: (3*3*512)*512 = 2,359,296
CONV3-512: [28x28x512]  memory:  28*28*512=400K   weights: (3*3*512)*512 = 2,359,296
POOL2: [14x14x512]  memory:  14*14*512=100K   weights: 0
CONV3-512: [14x14x512]  memory:  14*14*512=100K   weights: (3*3*512)*512 = 2,359,296
CONV3-512: [14x14x512]  memory:  14*14*512=100K   weights: (3*3*512)*512 = 2,359,296
CONV3-512: [14x14x512]  memory:  14*14*512=100K   weights: (3*3*512)*512 = 2,359,296
POOL2: [7x7x512]  memory:  7*7*512=25K  weights: 0
FC: [1x1x4096]  memory:  4096  weights: 7*7*512*4096 = 102,760,448
FC: [1x1x4096]  memory:  4096  weights: 4096*4096 = 16,777,216
FC: [1x1x1000]  memory:  1000 weights: 4096*1000 = 4,096,000

TOTAL memory: 24M * 4 bytes ~= 93MB / image (only forward! ~*2 for bwd)
TOTAL params: 138M parameters
与卷积网络一样,请注意,大部分内存(以及计算时间)都用在早期的 CONV 层中,并且大部分参数都在最后的 FC 层中。在这种特殊情况下,第一个 FC 层包含 100M 权重,总共 140M。
计算量与内存开销
构建 ConvNet 架构时需要注意的最大瓶颈是内存瓶颈。许多现代 GPU 的内存限制为 3/4/6GB,最好的 GPU 的内存约为 12GB。需要跟踪三个主要的内存来源:
- 从中间张量大小:这些是 ConvNet 每层激活的原始数量,以及它们的梯度(大小相等)。通常,大多数激活都发生在 ConvNet 的较早层(即第一个 Conv 层)上。这些之所以被保留,是因为反向传播需要它们,但仅在测试时运行 ConvNet 的巧妙实现原则上可以通过仅存储任何层的当前激活并丢弃下面层的先前激活来大幅减少这种情况。
- 从参数大小来看:这些是保存网络参数的数字,它们在反向传播期间的梯度,如果优化使用动量、Adagrad 或 RMSProp,通常也是步骤缓存。因此,单独存储参数向量的存储器通常必须乘以至少3倍左右的系数。
- 每个 ConvNet 实现都必须维护其他内存,例如图像数据批次,也许是它们的增强版本等。
一旦您粗略估计了值的总数(对于激活、梯度和杂项),该数字应转换为以 GB 为单位的大小。获取值的数量,乘以 4 以获得原始字节数(因为每个浮点数为 4 个字节,或者对于双精度可能乘以 8),然后多次除以 1024 以获得以 KB、MB 为单位的内存量,最后以 GB 为单位。如果网络占用的内存超出可用容量,降低内存占用的一种常见做法是减小批量大小,因为大部分内存通常被激活消耗。
补充资料
与实施相关的其他资源:
- Sumith CONV 性能基准
- ConvNetJS CIFAR-10 演示 允许您使用 ConvNet 架构并在浏览器中实时查看结果和计算。
- Caffe,流行的 ConvNet 库之一。
- Torch7 中最先进的 ResNet